
觀察報酬上的二元樹
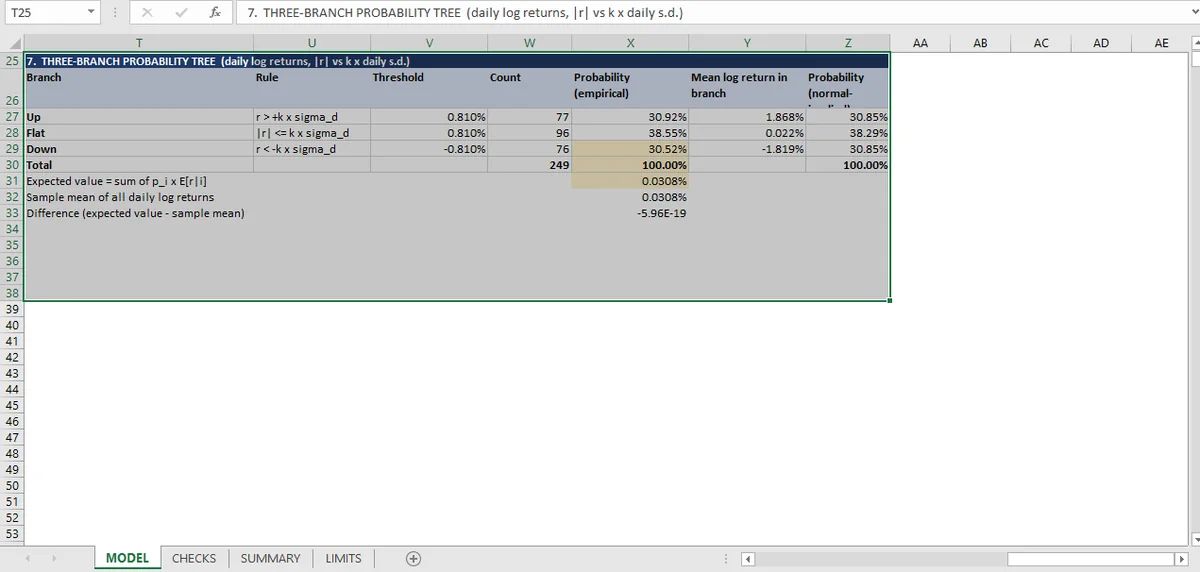
用 249 筆日報酬建立的兩分支樹,必須滿足三件事:機率加總為一、分支計數加總等於樣本、期望值從兩者重建。實證的上分支機率是 0.3092,對上常態隱含的 0.3085。
活頁簿從價格序列建出最簡單的機率樹:249 筆日對數報酬各自分類為上漲日或下跌日,而各自的實證機率由計數算出。
接著檢查兩件事,而第三件從它們而來。
機率加總為一。 上漲加下跌正好等於 1,不是近似。那是很基本的算術,也是抓得到分類規則漏洞的檢查。例如一個排除零報酬的門檻,會讓某些日子不落在任何分支。
分支計數加總等於觀察值數量。 上分支計數加下分支計數等於 249。這是機率造不了假的檢查:如果兩個百分比加總為一,計數卻不等於樣本,其中一個分支是在不同的列範圍上算的。
期望值從兩者重建。 分支值的機率加權和,必須等於獨立算出的期望值。這裡的差是 6 × 10⁻¹⁶。
常態隱含機率
有意思的是第四條檢查。樹的上分支機率也可以從配適同一組報酬的常態分布推導,而兩者應該接近。
| 來源 | 上分支機率 |
|---|---|
| 實證計數 | 0.3092 |
| 常態隱含 | 0.3085 |
差距是 0.0007,或七個基點的機率。那是在 249 個觀察值上做常態配適該產生的結果,而它同時是兩件事的證據:分類計數正確,以及在這個樣本大小下報酬沒有嚴重偏離常態。
它也沒有證明報酬是常態。上分支機率七個基點(0.07 個百分點)的差距是弱測試。上/下跌拆分是分布最粗的摘要,而一條厚尾序列可以精確符合它,卻在第 1 與第 99 百分位數失敗。
樹是做什麼用的
日資料上的兩分支樹不是嚴肅的不確定性模型。它是一個教學結構:有機率、分支與期望值的最小物件,因此也是能跑那三條一致性檢查的最小物件。
這就是為什麼它屬於檢查表。每個更大的模型都有同樣三個要求:決策樹、情境樹、樹狀網格。一個在兩個分支上失敗的模型,在兩百個分支上也會失敗。
該帶走的模式是第三條檢查。機率與計數都很容易在內部保持一致;從兩者重建期望值再比較,才抓得到在錯的範圍上算出的分支。
蒙地卡羅那篇 把兩個分支換成 10,000 條路徑,並保留同樣的想法:把模擬產生的東西對照分布在隱含的東西。三十一條檢查表的完整清單見量化頁面。餵給那些分支的報酬在報酬與時間價值,而在同一條序列上估計的 Beta 在迴歸那篇。
計數與機率分開存放,Mica 讓調節變成算術,而不是一句斷言。