
這本活頁簿沒有做的樣本外測試
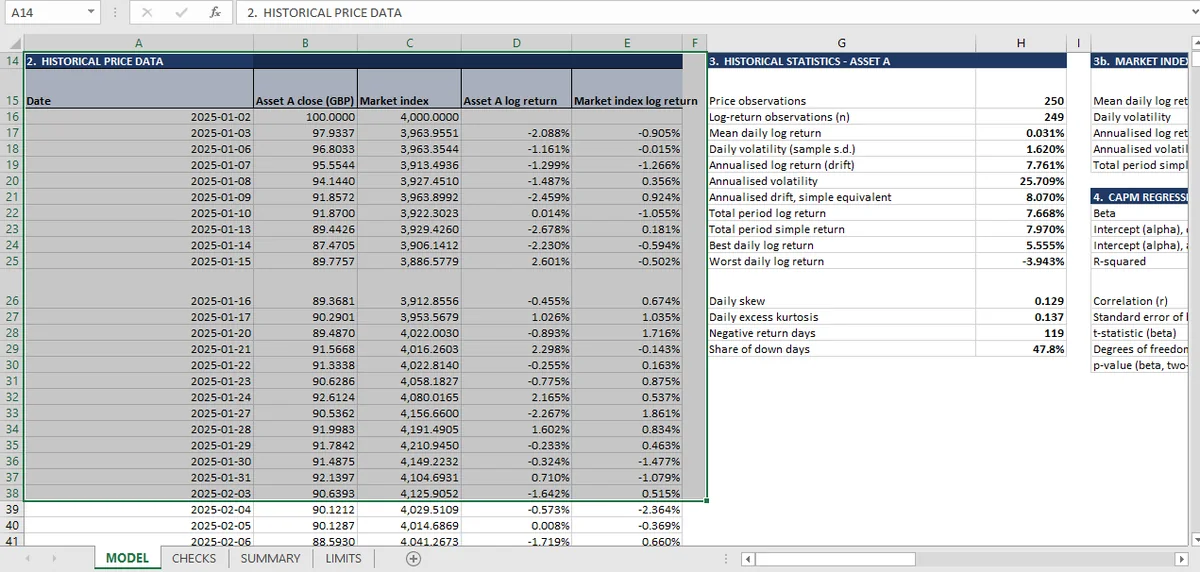
這本活頁簿的每個統計量都在同樣 249 天上計算,所以沒有任何東西是樣本外。要做切分,需要比目前輸入更多的資料;它洩漏的三種方式,是在全樣本上前處理、重疊視窗,以及看到結果之後才選切分。
量化活頁簿用 249 筆日報酬做一切:波動度、漂移、迴歸、模擬。每個統計量都在全樣本上計算,什麼都沒有保留。
那是一條限制,不是錯誤。活頁簿的工作是檢查算術對不對,而全樣本估計是最乾淨的做法。但把 25.71% 波動度與 −0.229 Beta 當成資產描述的讀者,跳過了一步,因為兩個數字描述的是它們被配適的那 249 天。
樣本外是什麼意思
把序列切成兩半。在前半估計,在後半評估。評估是樣本外,因為後半在配適中沒有扮演任何角色。
結果通常比樣本內配適差,而惡化的幅度就是資訊。一個樣本內配適 20% 變異、樣本外只有 2% 的模型,是在配適雜訊。一個配適 15% 與 12% 的模型,找到了東西。
對一個只有一年資料的單一資產,切分會在兩邊都留下太少東西,什麼都說不了。這就是為什麼活頁簿沒有做,也是為什麼正確地做需要比目前輸入更多的資料。
切分洩漏的三種方式
在全樣本上前處理。 如果報酬用整條序列標準化、溫莎化(winsorized)或去均值之後才切分,測試集已經影響了模型。平均數與標準差必須只來自訓練視窗。
重疊視窗。 一個在第 1–150 天訓練、第 100–249 天測試的模型,在第 100–150 天重疊,那些天兩邊都有。重疊不是小洩漏;那是模型在被它看過的資料上測試。
看到結果之後才選切分。 試五種切分、報出最好的,是穿著樣本外標籤的樣本內選擇。切分必須在模型配適之前就固定。
這些都不稀奇。三者在最終統計表裡都看不見,這就是為什麼檢查必須是結構性的:產生測試統計量的公式,必須完全不去參照測試期間的資料。
檢查表能斷言什麼
四條斷言,全是機械性的。
- 訓練視窗在測試視窗開始之前結束。
- 每一個用來配適模型的統計量,都只在訓練視窗上計算。
- 測試集在評估步驟之前未被碰觸。
- 樣本內與樣本外結果都報出來,並排。
最後一條是重要的一條,也是最常被跳過的一條。只顯示樣本外數字的表,藏起了放棄了多少;兩者都顯示的表,讓讀者看到惡化並判斷它。
量化活頁簿沒有納入這些檢查,它的限制表也沒有提到它們。那是一個被誠實揭露的缺口:模型檢查它算了什麼,對樣本是否夠長、夠有代表性以支撐預測,什麼都沒說。
為什麼這對其他主題要緊
這個系列每個模型都用固定樣本:四年帳目、一條價格序列、一張交易條件表。每一個案例裡,檢查確立內部一致性,而每一個案例裡,「這在別的資料上成立嗎」這個問題都懸而未決。
這種分工對示範來說合理,但當模型被用來預測時就不再合理;兩者的差別正是這裡描述的切分。
蒙地卡羅那篇 是唯一拿模型去對照它自身以外東西的一篇,也就是解析分布。那個比較之所以可行,只因為分布是被假設的。迴歸那篇 在 p 值裡顯示同樣的張力,量化頁面有三十一條檢查的完整清單。切分會切開的統計量在報酬與時間價值,而代替外部測試的解析比較在蒙地卡羅那篇。
估計視窗是工作表裡明說的範圍,Mica 這樣留下它;那是切分第一個必須改變的東西。