
Trois chiffres issus d'une régression
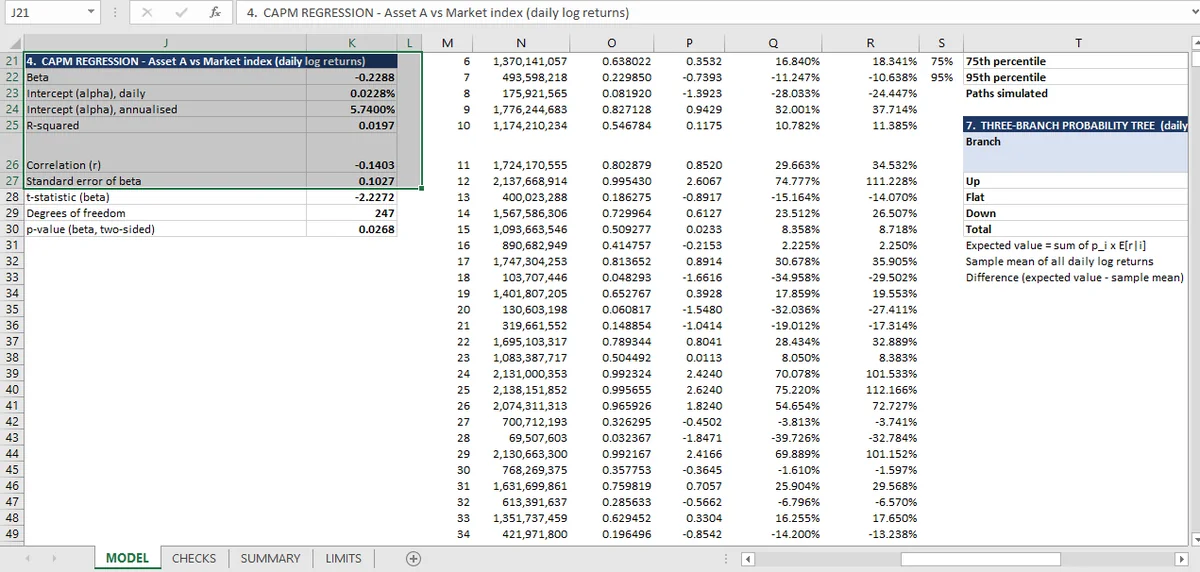
Un bêta de −0,229 avec une p-value de 0,0268 est statistiquement significatif à 5 %. Le R² est de 0,0197, donc le marché explique 2 % de la variation. Les deux chiffres sont rapportés, et ensemble ils disent que la relation est réelle mais presque inutile.
Le classeur exécute une régression des rendements logarithmiques quotidiens d'un actif sur un indice de marché et rapporte trois chiffres :
| Statistique | Valeur |
|---|---|
| Bêta | −0,229 |
| p-value | 0,0268 |
| R² | 0,0197 |
Chacun est contrôlé, et les contrôles valent la peine d'être compris parce qu'ils vont dans des directions différentes.
L'identité du bêta
Le bêta peut être calculé de deux façons : comme la pente de la régression, ou comme la corrélation fois le ratio des deux volatilités.
Les deux méthodes concordent ici à la treizième décimale. C'est un contrôle du codage, pas de l'interprétation économique : il confirme que la pente de la régression et la corrélation sont calculées à partir de la même série, avec les mêmes moyennes et les mêmes dénominateurs.
Il échouerait si, par exemple, la régression utilisait des rendements simples et la corrélation des rendements logarithmiques. Le décalage produit un bêta qui paraît plausible et qui est faux de quelques pour cent.
Le R² est le carré de la corrélation
La seconde identité : le R² égale le carré de la corrélation. 0,0197 pour les deux.
C'est là que les trois chiffres commencent à raconter une histoire. Un R² de 0,0197 signifie que l'indice explique 2 % de la variation des rendements de l'actif. Les 98 % restants ne sont pas dans cette régression, ce qui en fait une question d'analyse de données plutôt qu'une question de formule.
La p-value, et ce dont elle est la p-value
La p-value de 0,0268 dit que si le vrai bêta était nul, un échantillon de 249 observations produirait une pente au moins aussi grande environ 2,7 % du temps. Avec 249 observations, cela correspond à une statistique t d'environ 2,2.
Trois choses en découlent, et elles ne pointent pas toutes dans le même sens.
Le signe est fiable. Une p-value de 0,027 est sous le seuil conventionnel de 5 %, donc la relation négative a peu de chances d'être un artefact de cet échantillon particulier.
La magnitude ne l'est pas. Un intervalle de confiance à 95 % autour d'un bêta de −0,229 avec t = 2,2 va d'environ −0,43 à −0,03. Cette plage inclut « aucune couverture utile » et « une exposition vendeuse substantielle ».
Le pouvoir explicatif est négligeable. Le R² de 0,0197 est ce qui rend la significativité peu surprenante : avec 249 observations, presque toute relation non nulle sera significative. La significativité répond « est-ce là » ; le R² répond « est-ce que cela compte ».
Le contrôle que le modèle exécute est modeste (la p-value est dans [0,1]), et c'est un contrôle contre une erreur de retranscription plutôt qu'une affirmation statistique. Une p-value de 1,7 serait une erreur de formule ; 0,0268 est plausible.
Pourquoi une feuille de contrôle ne peut pas trancher
Les contrôles confirment que la régression est calculée correctement à partir de la série. Ils ne peuvent pas vous dire si la régression vaut la peine d'être exécutée.
Ce jugement dépend de l'usage du bêta. Pour un ratio de couverture, un bêta de −0,229 avec un R² de 2 % est presque inutile : la couverture compenserait 2 % de la variance et ajouterait son propre risque. Pour une exposition factorielle dans un modèle plus grand, ce peut être exactement l'entrée requise, avec le R² rapporté à côté pour que le lecteur sache quel poids lui donner.
Le classeur rapporte les deux, côte à côte, ce qui est la bonne structure. Un tableau de régression qui montre les coefficients et les étoiles mais cache le R² est la façon la plus fiable de tromper un lecteur avec des chiffres exacts.
Ce qui renforcerait la régression
Trois choses, dont aucune n'est dans le classeur.
Une erreur standard. La p-value implique une statistique t mais l'erreur standard n'est pas montrée, et c'est le chiffre dont un lecteur a besoin pour construire un intervalle.
Un second échantillon. Chaque statistique ici utilise les 249 observations. Un découpage (ajustement sur les 150 premières, test sur les 99 dernières) montrerait si la relation persiste, ce qui est la question hors échantillon dans sa forme la plus simple.
Un contrôle de normalité des résidus. La p-value suppose des résidus normaux. Les rendements quotidiens ne sont notoirement pas normaux, et la p-value est le chiffre le plus sensible à cette hypothèse.
La simulation qui utilise la même série est l'article Monte-Carlo, et la page des méthodes quantitatives rassemble les 31 contrôles. La série d'où viennent les deux statistiques est dans rendements et valeur temps, et la simulation qui suppose des rendements normaux est dans l'arbre de probabilités.
La sortie de régression reste, dans Mica, à côté de l'identité qui la contrôle ; le bêta peut donc être comparé à la corrélation fois le ratio des volatilités.