
Le test hors échantillon que le classeur ne fait pas
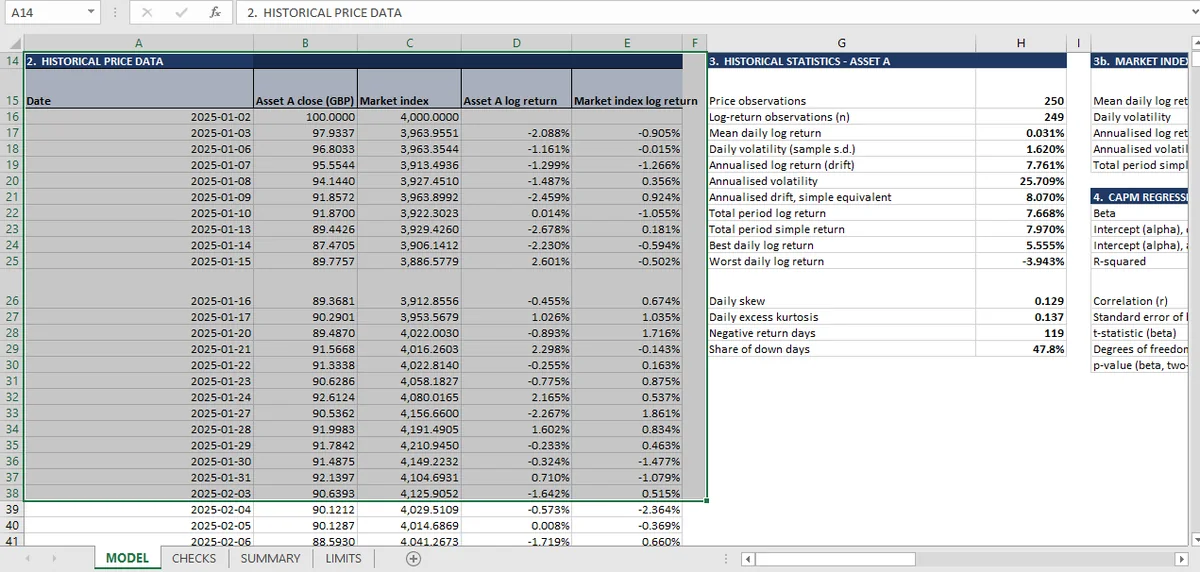
Chaque statistique de ce classeur est calculée sur les mêmes 249 jours, donc rien n'est hors échantillon. Un découpage demanderait plus de données que le dossier d'entrée n'en contient ; les trois façons dont il fuit sont le prétraitement sur l'échantillon complet, les fenêtres chevauchantes et le choix du découpage après avoir vu les résultats.
Le classeur quantitatif utilise 249 rendements quotidiens pour tout : la volatilité, la dérive, la régression, la simulation. Chaque statistique est calculée sur l'échantillon complet, et aucune donnée n'est mise de côté.
C'est une limite, pas une erreur. Le travail du classeur est de vérifier que l'arithmétique est juste, et une estimation sur échantillon complet est la façon la plus propre de le faire. Mais un lecteur qui prend la volatilité de 25,71 % et le bêta de −0,229 comme des descriptions de l'actif a sauté une étape, parce que les deux chiffres décrivent les 249 jours sur lesquels ils ont été ajustés.
Ce que signifie hors échantillon
Découpez la série en deux. Estimez sur la première partie, évaluez sur la seconde. L'évaluation est hors échantillon parce que la seconde partie n'a joué aucun rôle dans l'ajustement.
Le résultat est généralement moins bon que l'ajustement dans l'échantillon, et la taille de la dégradation est l'information. Un modèle qui explique 20 % de la variance dans l'échantillon et 2 % hors échantillon modélisait du bruit. Un modèle qui explique 15 % et 12 % a trouvé quelque chose.
Pour un actif unique avec un an de données, un découpage laisse trop peu de chaque côté pour dire quoi que ce soit. C'est pourquoi le classeur ne le fait pas, et pourquoi le faire correctement exige plus de données que le dossier d'entrée n'en contient.
Les trois façons dont un découpage fuit
Prétraitement sur l'échantillon complet. Si les rendements sont standardisés, tronqués aux extrémités (winsorisés) ou centrés en utilisant toute la série puis découpés, l'ensemble de test a influencé le modèle. La moyenne et l'écart-type doivent venir de la seule fenêtre d'entraînement.
Fenêtres chevauchantes. Un modèle entraîné sur les jours 1 à 150 et testé sur les jours 100 à 249 se chevauche aux jours 100 à 150, présents dans les deux. Le chevauchement n'est pas une petite fuite ; c'est le modèle testé sur des données qu'il a vues.
Choisir le découpage après avoir vu les résultats. Essayer cinq découpages et rapporter le meilleur est une sélection dans l'échantillon portant une étiquette hors échantillon. Le découpage doit être fixé avant l'ajustement du modèle.
Rien de tout cela n'est exotique. Les trois sont invisibles dans un tableau final de statistiques, ce qui explique pourquoi le contrôle doit être structurel : le code qui produit la statistique de test ne doit pas pouvoir voir les lignes de test.
Ce qu'une feuille de contrôle peut affirmer
Quatre contrôles, tous mécaniques.
- La fenêtre d'entraînement se termine avant le début de la fenêtre de test.
- Chaque statistique utilisée pour ajuster le modèle est calculée sur la seule fenêtre d'entraînement.
- L'ensemble de test reste intact jusqu'à l'étape d'évaluation.
- Les résultats dans l'échantillon et hors échantillon sont rapportés, côte à côte.
La dernière est la plus importante, et c'est la plus souvent sautée. Un tableau qui ne montre que le chiffre hors échantillon cache combien a été abandonné ; un tableau qui montre les deux permet au lecteur de voir la dégradation et de la juger.
Le classeur quantitatif ne porte pas ces contrôles, et sa feuille des limites ne les mentionne pas non plus. C'est la lacune assumée : le modèle contrôle ce qu'il a calculé, et ne dit rien du point de savoir si l'échantillon est assez long, ou assez représentatif, pour étayer une prévision.
Pourquoi cela compte pour les autres sujets
Chaque modèle de cette série utilise un échantillon fixe : quatre ans de comptes, une série de prix, une fiche de conditions. Dans chaque cas, les contrôles établissent la cohérence interne, et dans chaque cas la question « cela tiendrait-il sur d'autres données » reste ouverte.
Cette répartition du travail est raisonnable pour une démonstration ; elle cesse de l'être quand le modèle sert à prédire. La différence entre les deux est exactement le découpage décrit ici.
L'article Monte-Carlo est la seule pièce qui compare le modèle à quelque chose d'extérieur à lui, la distribution analytique. Cette comparaison n'est disponible que parce que la distribution a été supposée. L'article sur la régression montre la même tension dans une p-value, et pour les 31 contrôles, voir la page des méthodes quantitatives. Les statistiques qu'un découpage diviserait sont dans rendements et valeur temps, et la comparaison analytique qui tient lieu de test externe est dans le Monte-Carlo.
Dans Mica, la fenêtre d'estimation reste une plage énoncée dans la feuille : c'est la première chose qu'un découpage doit modifier.