
Ce qu'est réellement le classeur
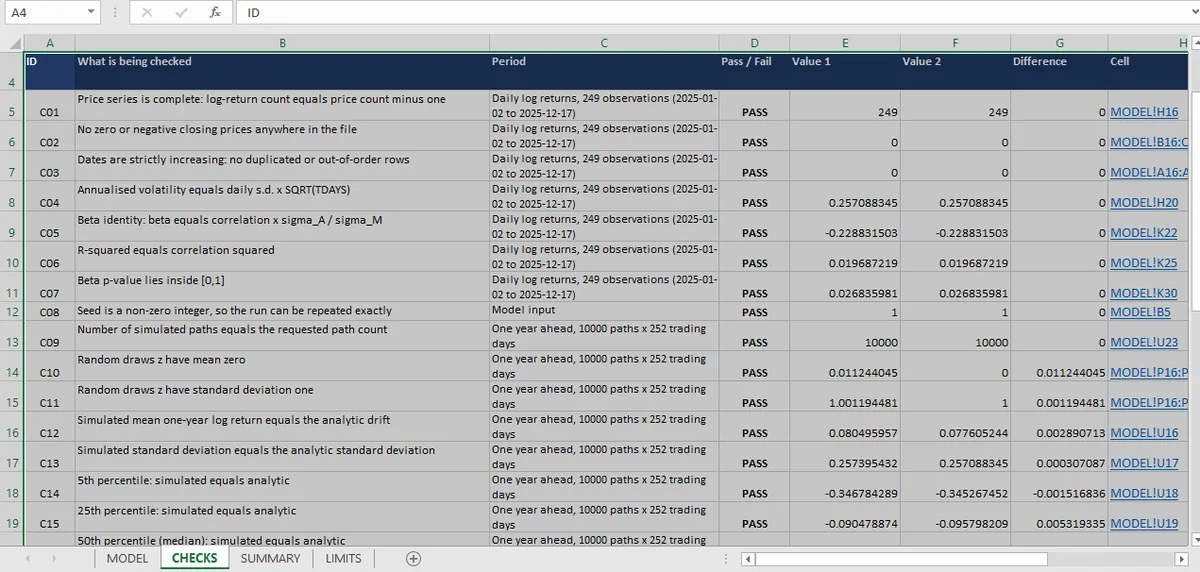
Trente et un contrôles sur une série de prix : trois pour l'intégrité des données, quatre identités, sept pour la simulation, quatre échelles de distribution, cinq pour l'arbre, et le reste sur le reporting de régression. Chaque groupe répond à une question dont dépend le suivant.
Une série de prix, quatre questions, trente et un contrôles.
Les questions sont : les données sont-elles propres, les statistiques sont-elles calculées selon leurs définitions, la simulation reproduit-elle la distribution qu'elle suppose, et la régression se comporte-t-elle comme annoncé.
| Groupe | Contrôles | Ce qu'il établit |
|---|---|---|
| Intégrité des données | 3 | 249 rendements à partir de 250 prix, aucun cours nul, dates dans l'ordre |
| Identités | 4 | Volatilité, bêta, R² et p-value suivent leurs définitions |
| Simulation | 7 | Avec graine, 10 000 trajectoires, moments concordants, centiles concordants |
| Distributions et échelles | 4 | L'ordre tient pour le simulé et l'analytique |
| Arbre | 5 | Probabilités et comptages se réconcilient avec les observations |
| Reporting de régression | 2 | Identité du bêta et carré de la corrélation |
| Comparaisons de centiles et de moments | 6 | Simulé contre analytique, simple contre lognormal |
Le schéma qui rend ce sujet différent
Dans le modèle à trois états, un contrôle compare un chiffre à un autre chiffre du même classeur. Ici, six contrôles comparent la simulation à une formule que le classeur calcule aussi, et cette formule est l'hypothèse du modèle lui-même.
C'est à la fois plus faible et plus fort que cela n'en a l'air. Plus faible, parce qu'une simulation construite sur une hypothèse lognormale et vérifiée par rapport à des centiles lognormaux ne peut pas détecter une hypothèse fausse. Plus fort, parce que c'est la seule comparaison de la série où une méthode numérique est testée contre une réponse en forme fermée, et c'est exactement le test dont un Monte-Carlo a besoin : sans référence analytique, une simulation est un générateur de chiffres avec une graine.
Les trois chiffres à retenir
25,71 % de volatilité, calculée comme l'écart-type quotidien fois la racine de l'année boursière, et contrôlée contre cette identité.
Bêta de −0,229, avec un R² de 0,0197. Significatif à 5 %, expliquant 2 %. Le classeur rapporte les deux, et le couple est la chose la plus utile qu'il contient.
Un écart de centiles maximal de 0,0053. C'est l'erreur d'échantillonnage de 10 000 trajectoires en termes de rendement logarithmique, et cela chiffre la précision avec laquelle la distribution est connue.
Ce que rien de tout cela ne couvre
Quatre choses, et elles sont structurelles plutôt que des omissions.
Un actif, un an. Pas de portefeuille, pas de covariance, pas de second régime. Chaque statistique décrit 249 jours.
La distribution est supposée. Pas de test de normalité, pas de test d'autocorrélation, pas de grappes de volatilité. Les contrôles confirment que la simulation correspond à l'hypothèse, pas que l'hypothèse est juste.
Pas de découpage hors échantillon. Chaque chiffre est dans l'échantillon, et la feuille des limites ne dit pas autre chose.
Pas de frontière efficiente. Le classeur lui-même est un simulateur de rendement et de risque ; l'optimiseur sous contraintes se trouve dans le sujet portefeuille.
Comment lire la feuille
Commencez par les contrôles de données, parce que tout le reste en hérite. Puis les identités, qui sont le moyen le moins cher de détecter une formule fausse. Puis la comparaison de simulation, seul endroit où une méthode numérique rencontre sa forme fermée. Puis le reporting de régression, où le modèle laisse le jugement au lecteur.
Cet ordre est celui que la feuille de contrôle du classeur utilise, et c'est la raison pour laquelle 31 suffisent : chaque groupe répond à une question dont dépend le suivant.
L'article sur les rendements commence par les données, le volet Monte-Carlo est la comparaison en forme fermée, l'article sur le bêta est le jugement, et la feuille de contrôle intégrale figure sur la page des méthodes quantitatives. Le plus petit objet de la feuille est l'arbre de probabilités, et la couche que ce classeur laisse de côté est la frontière efficiente.
Dans le classeur, Mica a construit le modèle ; simulation, régression et contrôles lisent donc la même série de rendements.