
Les trois premiers contrôles portent sur le fichier
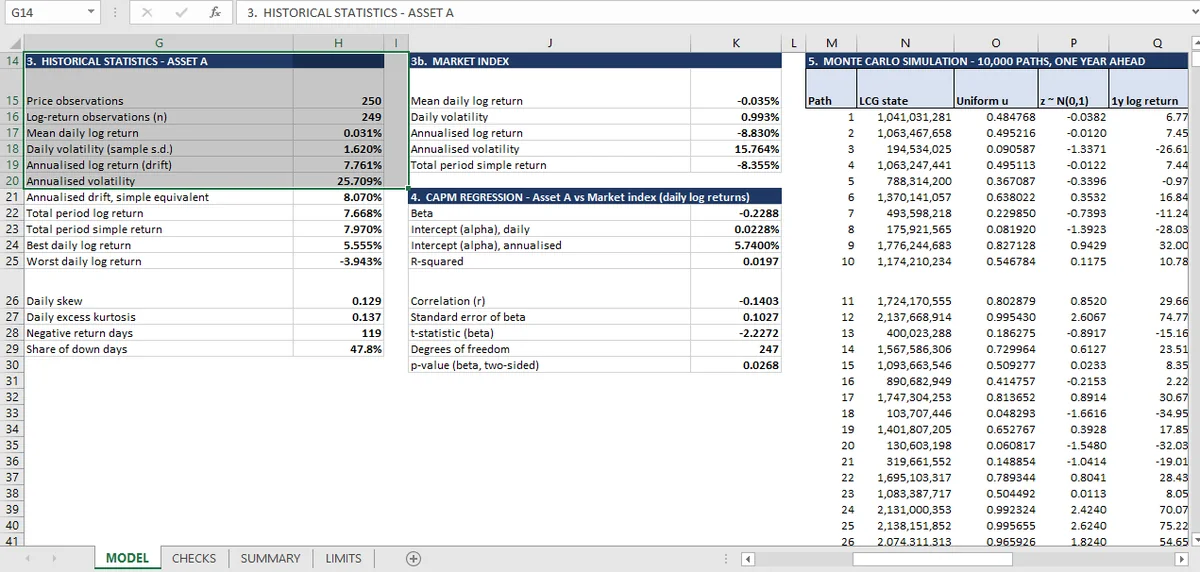
La volatilité annualisée est l'écart-type quotidien fois la racine de l'année boursière : 25,71 % sur 249 rendements. La dérive logarithmique est de 7,76 %, la moyenne analytique de la lognormale est de 11,70 %, et la moyenne simulée des rendements simples est plus élevée, à 12,03 %, parce que la moyenne d'une lognormale se situe au-dessus de sa moyenne logarithmique.
Avant tout calcul statistique, trois choses doivent être vraies de la série de prix : le nombre de rendements est inférieur de un au nombre de prix, aucun cours de clôture n'est nul ou négatif, et les dates sont strictement croissantes.
Les trois contrôles paraissent élémentaires ; ce sont les défaillances qui corrompent tout ce qui suit sans lever d'erreur, et ils sont la première étape du nettoyage d'une série de rendements.
Une ligne manquante change le nombre de rendements, et avec lui toute statistique fondée sur un comptage. Une série de 249 prix là où il devrait y en avoir 250 produit 248 rendements, et la volatilité annualisée calculée à partir d'eux est un chiffre qui paraît correct.
Un prix nul produit un rendement logarithmique infini. Excel affichera #NOMBRE! (en anglais, #NUM!) dans cette cellule, mais si le rendement est ensuite moyenné avec AGREGAT (en anglais, AGGREGATE), qui ignore les erreurs, la moyenne est calculée sans avertissement sur le reste de la série. Le contrôle qu'aucun prix n'est nul ou négatif est la défense la moins chère contre toute une classe d'erreurs invisibles.
Des dates dans le désordre produisent des rendements qui couvrent le mauvais intervalle : un rendement du vendredi au mercredi, puis du mardi au jeudi. Rien ne produit d'erreur. Les rendements logarithmiques calculés sur des lignes mélangées redonnent encore le rendement total, ce qui rend l'erreur si difficile à voir.
Les trois contrôles réussissent ici : 249 rendements à partir de 250 prix, zéro clôture non positive, zéro violation d'ordre.
Les 250 clôtures ont été lues dans un fichier de prix PDF, et certains cours ont demandé plus d'une passe d'OCR. Les contrôles de données détectent une ligne manquante, un prix nul et une date hors ordre ; ils ne détectent pas un chiffre lu comme 8 au lieu de 6. Cette erreur changerait chaque statistique en aval ; les contrôles de données sont structurels, et la retranscription est hors de leur portée.
L'identité de la volatilité
La première vraie statistique est la volatilité annualisée : 25,71 %.
Le contrôle est une identité plutôt qu'une comparaison avec un chiffre externe : la volatilité annualisée doit égaler l'écart-type quotidien multiplié par la racine des jours de cotation de l'année. Si le modèle saisit un chiffre en dur, ou utilise 365 au lieu du calendrier de cotation, ou calcule l'écart-type sur des rendements simples plutôt que logarithmiques, l'identité échoue.
C'est ce qui rend un contrôle d'identité utile sur une série unique. Il n'y a pas de source externe à laquelle comparer 25,71 %, mais il y a une définition, et le modèle doit la satisfaire.
La dérive, et la différence entre deux moyennes
La dérive logarithmique annualisée est de 7,76 %. Deux moyennes apparaissent dans le classeur, et ce ne sont pas les mêmes.
La moyenne arithmétique des rendements logarithmiques est le paramètre de dérive qui entre dans la simulation. Elle vaut 0,0776.
La moyenne des rendements simples est plus élevée : 0,1203 dans la simulation, contre une moyenne lognormale analytique de 0,1170. La moyenne d'une lognormale dépasse l'exponentielle de sa moyenne logarithmique de la moitié de la variance. Cette relation est un contrôle à part entière.
Citer « le rendement moyen » sans dire de quelle moyenne il s'agit est l'une des erreurs les plus courantes de la rédaction quantitative, et l'écart ici est de 4 points de pourcentage par an sur un actif qui rapporte 8 %.
Pourquoi ces contrôles de rendements et de valeur temps sont courts
Parce que les contrôles sont courts. Trois tests d'intégrité de fichier et quatre identités n'ont pas besoin d'une longue défense ; ils ont besoin d'être exécutés.
Ce qu'ils établissent, c'est que l'entrée de tout le reste est une série propre et que les trois statistiques de base sont calculées à partir de leurs définitions. Ce qu'ils n'établissent pas, c'est que la série est un bon échantillon. 249 jours, c'est un an, un régime, un actif.
La simulation qui consomme ces chiffres est l'article Monte-Carlo ; la régression qui utilise la même série est le volet bêta ; et le relevé intégral des 31 contrôles figure sur la page des méthodes quantitatives. La version à deux branches de la même série est dans l'arbre de probabilités, et la couche portefeuille au-dessus est dans la frontière efficiente.
Sur la ligne des rendements, Mica calcule les statistiques de la série comme des formules ; un prix modifié se propage donc jusqu'au chiffre annualisé.