
Monte-Carlo : une série de prix, 31 contrôles
Le cas. Une série de prix en entrée : 250 clôtures quotidiennes issues d'un fichier de prix PDF, soit 249 rendements logarithmiques, pour un seul actif, plus un indice de marché pour la régression. Tout le reste en est calculé — volatilité annualisée, dérive logarithmique, régression et distribution à un an simulée avec 10 000 trajectoires à partir de la graine 20250101. La feuille des limites la traite comme un seul actif et un seul échantillon : pas de portefeuille, pas de seconde série, pas de test hors échantillon. Un exemple détaillé d'import CSV d'une série de rendements figure dans le parcours CSV/MA10. Il s'agit d'un cas synthétique destiné à démontrer une méthode, non d'un conseil en investissement, fiscal ou juridique.
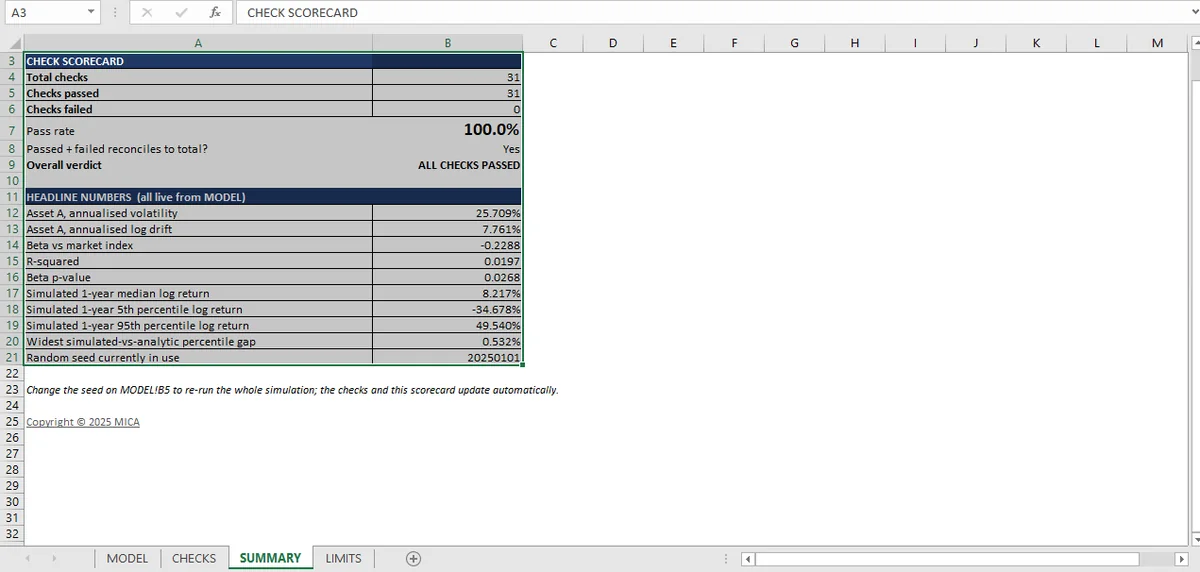
Une série de prix, 249 rendements, dix mille trajectoires à graine fixe. La volatilité est de 25,71 %, le bêta de −0,229 avec un R² de 0,0197, et cinq centiles simulés concordent avec la formule lognormale à 0,0053 près.
| Mesure | Résultat |
|---|---|
| Observations | 250 prix, 249 rendements logarithmiques |
| Volatilité annualisée | 25,71 % |
| Dérive logarithmique annualisée | 7,76 % |
| Bêta contre l'indice de marché | −0,229 |
| R² | 0,0197 |
| p-value du bêta | 0,0268 |
| Trajectoires simulées | 10 000 |
| Graine | 20250101 |
Trente et un contrôles étayent le classeur. Tous sont validés.
La simulation concorde avec l'hypothèse sur laquelle elle a été construite. C'est un résultat de cohérence, pas une validation de l'hypothèse.
Ce que montrent trente et un contrôles
Les contrôles se répartissent en quatre groupes, et chacun teste une couche différente.
Les données (3 contrôles). 249 rendements logarithmiques à partir de 250 prix, aucun cours de clôture nul ou négatif, dates strictement croissantes. Ils sont élémentaires et ce sont les premières choses qui échouent : une série triée dans le désordre change silencieusement chaque rendement et chaque statistique en aval. Le volet nettoyage de cette série est dans le guide de nettoyage de données.
Les identités (4 contrôles). La volatilité annualisée égale l'écart-type quotidien fois la racine de l'année boursière ; le bêta égale la corrélation fois le ratio des deux volatilités ; le R² égale le carré de la corrélation ; la p-value est dans [0,1]. Chacune est une relation qui doit tenir quelles que soient les données, donc un échec est toujours une erreur de codage.
La simulation (7 contrôles). La graine est un entier non nul, donc l'exécution est reproductible. Le nombre de trajectoires est de 10 000. Les tirages aléatoires ont une moyenne nulle et un écart-type de un. La moyenne et l'écart-type simulés correspondent à la dérive et à la volatilité analytiques. Les centiles correspondent aux centiles lognormaux analytiques.
Les tests d'ordre (4 contrôles). L'échelle de centiles (P5 < P25 < P50 < P75 < P95) tient de bout en bout, pour la distribution simulée comme pour l'analytique.
Pourquoi une simulation a besoin d'une réponse analytique
Un Monte-Carlo n'est contrôlable que si vous savez ce qu'il devrait produire. Ici, la réponse est une distribution lognormale : étant donnés la dérive et la volatilité, les 5e, 25e, 50e, 75e et 95e centiles à un an sont en forme fermée.
| Centile | Simulé | Analytique | Écart |
|---|---|---|---|
| 5e | −0,3468 | −0,3453 | 0,0015 |
| 25e | −0,0905 | −0,0958 | 0,0053 |
| 50e | 0,0822 | 0,0776 | 0,0046 |
| 75e | 0,2535 | 0,2510 | 0,0025 |
| 95e | 0,4954 | 0,5005 | 0,0051 |
L'écart le plus large est de 0,0053 en termes de rendement logarithmique, ce qui est l'erreur d'échantillonnage de 10 000 trajectoires, pas une erreur de modélisation. C'est le contrôle qui rend la simulation crédible : le modèle ne produit pas seulement une distribution, il produit la distribution que la théorie dit qu'il devrait produire.
Le bêta qui est significatif et n'explique rien
Le bêta est de −0,229 avec une p-value de 0,0268, statistiquement significatif au seuil de 5 %. Le R² est de 0,0197, ce qui signifie que l'indice de marché explique 2 % de la variation des rendements de cet actif.
Les deux faits sont vrais et ils vont dans des directions opposées pour qui les lit vite. Un bêta significatif dit que l'estimation a peu de chances d'être nulle ; un R² de 2 % dit que la relation est trop faible pour être utile à expliquer les rendements. Le classeur rapporte les deux, côte à côte, seule façon honnête de présenter une régression sur 249 observations.
Le reste de la série
Rendements et valeur temps est la donnée et les trois statistiques de base. L'arbre de probabilités est le plus petit objet dont les probabilités doivent totaliser un. Le Monte-Carlo est l'exécution à 10 000 trajectoires contre sa forme fermée. La régression est le bêta qui est significatif et n'explique rien. La frontière efficiente porte sur les contraintes d'un optimiseur que ce classeur ne contient pas. Le test hors échantillon est le test qui manque. L'article d'intégration explique comment les 31 contrôles s'emboîtent.
Ce que l'échantillon ne peut pas vous dire
La feuille des limites les énonce, et quatre comptent.
Un actif, une série. Pas de portefeuille, pas de second actif, pas de matrice de covariance. Ce que la simulation dit de l'actif A ne dit rien d'un portefeuille qui en contient. La couche portefeuille qui consomme une matrice de covariance est l'optimiseur de portefeuille.
La distribution est supposée, pas testée. Les rendements sont modélisés comme normaux en termes logarithmiques. Le classeur ne teste pas la série de prix pour la normalité, l'autocorrélation ou les grappes de volatilité. Il suppose la lognormalité, puis vérifie la simulation par rapport à cette hypothèse.
Pas de test hors échantillon. Chaque statistique est calculée sur les 249 observations complètes. Aucune donnée n'est mise de côté, donc rien n'établit que le modèle prédit.
La graine le rend reproductible, pas correct. Un générateur avec graine signifie que les mêmes trajectoires sont produites à chaque fois. Cela ne signifie pas que les trajectoires sont tirées de la bonne distribution. C'est la comparaison des centiles qui teste cela.
Le résumé utile est celui que les quatre groupes donnent déjà : les données sont propres, les identités tiennent, la simulation reproduit sa réponse analytique, et la régression est statistiquement significative tout en n'expliquant presque rien. Trois de ces points sont des contrôles ; le quatrième est un jugement que le classeur remet au lecteur.
La graine reste une cellule dans Mica ; toute la simulation peut donc être réexécutée et revérifiée sur les mêmes trajectoires.
Questions fréquentes
Combien de simulations Monte-Carlo faut-il lancer ?
Assez pour que la statistique rapportée ait convergé ; 10 000 trajectoires sont un point de départ courant. Ce classeur en utilise 10 000 à partir d'une graine stockée dans une cellule (20250101), donc la même exécution peut être répétée exactement.
Comment valider une simulation Monte-Carlo ?
Comparez-la à un cas qui a une réponse en forme fermée, puis contrôlez la convergence à mesure que les trajectoires augmentent et la répétabilité à partir d'une graine fixe. Ici, les 5e à 95e centiles sont à 0,0053 des valeurs lognormales en forme fermée.
Un bêta statistiquement significatif est-il utile si le R² est faible ?
La significativité dit que la pente a peu de chances d'être nulle ; le R² dit quelle part de la variation elle explique. Ici, le bêta est significatif à p = 0,0268, mais le R² est de 0,0197, donc le marché explique environ 2 % de la variation et le bêta est un mauvais prédicteur même s'il est réel.
Pourquoi donner une graine à une simulation Monte-Carlo ?
Une graine rend l'exécution reproductible : la même graine et les mêmes tirages donnent la même réponse, donc un contrôle peut être réexécuté et audité. Rien dans cette simulation n'utilise la fonction volatile ALEA() (en anglais, RAND()).