
Ce que mesurent les classements d'outils d'IA pour la modélisation financière
Les classements publiés notent la vitesse, la mise en forme et l'exactitude des données. Aucun des outils testés n'a calculé les intérêts à partir des soldes qui les génèrent ; aucun n'a donc construit un véritable modèle à trois états. L'axe absent est la capacité de vérification : le fichier fini contient-il des contrôles qu'un relecteur peut réexécuter ?
Le test le plus connu des outils d'IA pour la modélisation financière est celui de Wall Street Prep. Il demande à chaque outil de construire un modèle à trois états entièrement intégré pour Apple, avec trois ans d'historique tirés du 10-K et des résultats du quatrième trimestre, quatre ans de prévisions issues du consensus, et une mise en forme semblable à celle d'une banque. Les outils sont ensuite notés comme le serait un analyste en formation.
Les résultats, d'après le classement publié : Shortcut 5,9, Claude 5,5, Copilot 4,4, ChatGPT 2,5. Un analyste junior de niveau faible obtient 6,4 ; un niveau moyen, 7,9 ; un niveau élevé, 9,4. Aucun outil n'a atteint le niveau le plus faible des analystes humains.
Les catégories sont celles qui comptent pour qui doit transmettre un modèle à un collègue : la rapidité avec laquelle l'outil a compris la consigne, l'exactitude des chiffres historiques, la ressemblance de la mise en forme avec celle d'une banque, la solidité des sources et la qualité de la structure de prévision.
C'est un bon test, et il répond à une vraie question : si je demande à un outil de produire un modèle, quelle part du brouillon vais-je garder ? Il ne répond pas à la question qui détermine si le modèle est utilisable : le fichier fini peut-il être contrôlé ?
Ce que les classements laissent de côté : la vérifiabilité
Deux des catégories de ce test frôlent la capacité de vérification sans l'atteindre. La rubrique des sources demande si l'outil explique d'où vient un chiffre. La structure demande si les états sont cohérents entre eux. Aucune ne pose la question que pose un relecteur : puis-je réexécuter ceci et obtenir la même réponse, et puis-je trouver l'endroit où cela cesse d'être vrai ?
Le benchmark rapporte tout de même un résultat qui montre le coût de cet écart. À la rubrique circularité, le classement titre Tous ont échoué : « aucun outil n'a prévu les produits et charges d'intérêts à partir des soldes de trésorerie et de dette », et donc « aucune circularité n'avait été modélisée ». Sur la dette : « aucun n'a traité la dette correctement », et la plupart « se sont appuyés sur des variables d'ajustement plutôt que sur une vraie intégration ».
Ce ne sont pas de petites omissions dans un modèle à trois états. Un intérêt qui ne réagit pas au solde sur lequel il est calculé est une constante, et un bilan qui s'équilibre grâce à une variable d'ajustement satisfait l'identité à chaque période tout en étant faux à chaque période. Les outils n'ont pas échoué à résoudre un problème difficile ; ils ont évité le problème et ont quand même obtenu entre 4,4 et 5,9 sur 10.
Un classement ne peut pas voir cela, parce qu'un classement compare des résultats à une grille de notation. La capacité de vérification tient à la démarche, pas au résultat.
Sur quoi un modèle vérifiable devrait être noté
L'alternative n'est pas une meilleure grille de notation pour le même brouillon. C'est une autre question, qui porte sur le fichier plutôt que sur l'outil : combien de conditions le classeur fini remplit-il, et quelqu'un d'autre que son auteur peut-il le démontrer ?
Six types de contrôles couvrent cela, et chacun produit un chiffre plutôt qu'une impression :
| Type de contrôle | Ce qu'il produit | Pourquoi un classement passe à côté |
|---|---|---|
| Structurel | Identités tenues, par période | Un modèle peut s'équilibrer seulement dans la dernière colonne |
| Cohérence | Formules concordantes d'une période à l'autre | Une retouche manuelle a l'air d'une formule |
| Contraintes | La solution respecte les limites déclarées | Un optimum hors limites ressemble encore à une réponse |
| Convergence | Deux méthodes, un chiffre, un écart | Une méthode unique ne peut pas se vérifier seule |
| Sensibilité | Sens et plausibilité de la réaction | Un modèle uniformément faux passe tout le reste |
| Comportement connu | Comportements connus identifiés, pas comptés comme fautes | Un modèle juste peut être déclaré faux |
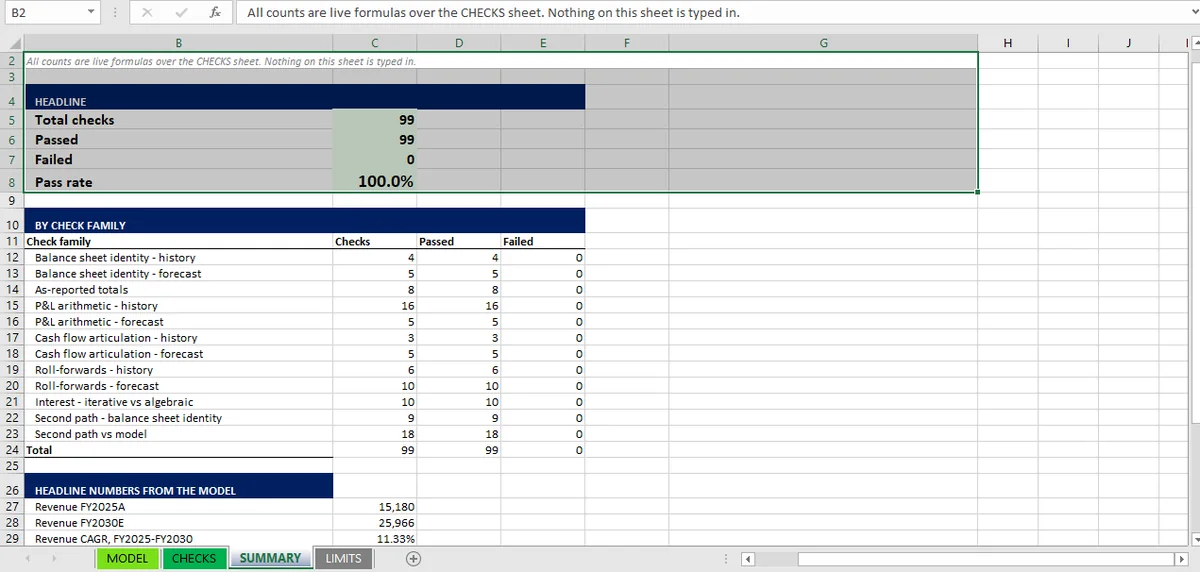
Le classeur de cette série a été construit pour produire exactement ces chiffres, et le résultat est sans éclat : 99 contrôles, 99 validés, et un constat, une trésorerie de clôture de −1 113, parce qu'aucune ligne de financement n'existe. Le chiffre qui compte n'est pas le 99. C'est le dernier, qu'aucune note sur 10 n'aurait mis en évidence.
Comment les outils se comparent sur les contrôles
On ne peut pas encore comparer les outils entre eux, et il vaut la peine d'expliquer pourquoi plutôt que de suggérer un classement.
Appliquer le protocole de contrôle à un outil suppose de lui fournir le même dossier de départ, de conserver la même solution de référence et de noter le classeur produit selon les mêmes 99 conditions. Cela a été fait une fois, sur un modèle, par une équipe (celui-ci), et le résultat est une démonstration plutôt qu'une enquête.
Ce qui peut être comparé, à partir des tests publiés, c'est le comportement des outils là où les contrôles échouent généralement :
| Ce qui est mesuré | Shortcut | Claude in Excel | Copilot | ChatGPT |
|---|---|---|---|---|
| Prévision des intérêts à partir des soldes de trésorerie et de dette | Non | Non | Non | Non |
| Échéancier de dette traité correctement | Non | Non | Non | Non |
| Note globale, test publié | 5,9 | 5,5 | 4,4 | 2,5 |
Quatre outils, une seule réponse sur les deux points qui décident si un modèle à trois états mérite le nom de modèle. C'est un résultat publié, sur un test précis et à une date précise, et c'est la preuve la plus solide dont on dispose pour affirmer que la vitesse de production et la capacité de vérification sont deux axes différents.
Ce résultat ne signifie pas qu'aucun outil ne peut réussir le protocole de contrôle. Le protocole a été appliqué une fois, et l'outil qui l'a réussi était Mica ; ce résultat doit se lire avec la réserve évidente : la même équipe a construit le modèle et écrit les contrôles. Cette réserve explique pourquoi chaque article de ce site distingue un contrôle croisé à l'intérieur d'un classeur d'un audit externe, et pourquoi les chiffres sont publiés en entier plutôt que résumés.
Les questions à poser à un fournisseur
Si vous choisissez un outil pour un travail sur lequel on va s'appuyer, le classement est un point de départ et les cinq questions qui suivent font le reste. On peut y répondre lors d'une démonstration, et ces réponses peuvent être vérifiées.
- L'outil laisse-t-il une feuille de contrôle dans le fichier ? Pas un rapport, pas un résumé dans la fenêtre de chat : des lignes dans le classeur qui se recalculent quand le modèle change.
- Calcule-t-il quelque chose deux fois ? Les intérêts, le rendement, la duration, le prix d'une option. Si la réponse est non, demandez quelle grandeur il vérifie vraiment, et de quelle manière.
- Puis-je supprimer un tableau et voir ce qui casse ? Cela teste si les parties du modèle sont liées ou simplement juxtaposées.
- Que dit la feuille des limites ? Un outil qui ne produit aucune feuille des limites affirme que le modèle couvre tout, et c'est justement l'affirmation qui est toujours fausse.
- Puis-je réexécuter la même consigne sur le même fichier demain ? L'exécution en local compte ici : si le classeur quitte la machine entre deux exécutions, la chaîne de preuves a un trou.
Mica sépare les hypothèses d'entrée des cellules calculées, si bien qu'un changement de scénario peut être retracé jusqu'aux résultats qu'il a touchés. C'est une réponse aux questions 1 et 5, et elle se vérifie dans le classeur, pas sur une page publicitaire.
Le paysage des outils derrière ces questions est comparé dans le guide des outils Excel IA gratuits et la comparaison ChatGPT/Claude/Copilot ; l'article sur la tendance des bots d'action offre la vue d'ensemble au niveau de la catégorie.
Qui doit lire le classement, et qui ne doit pas
Les notes publiées répondent à une vraie question pour un type d'acheteur et à une question trompeuse pour un autre.
Si vous écrivez pour réfléchir, le classement correspond presque exactement à ce qu'il vous faut. Un outil qui obtient 5,9 et termine le modèle en quinze minutes change réellement la vitesse à laquelle vous produisez une première version, et les erreurs qui le tiennent hors du niveau des analystes humains sont celles que vous auriez faites de toute façon au premier jet. Servez-vous-en, puis reconstruisez les parties qui comptent.
Si le modèle doit être transmis, le classement est le mauvais instrument. La note décrit un brouillon qu'un analyste compétent doit encore terminer ; elle ne dit rien de la possibilité, pour un tiers, de relire le fichier fini. C'est la question de la feuille de contrôle, et aucun des quatre outils n'y répond aujourd'hui.
Si vous achetez un logiciel pour une équipe, exigez les deux. La note vous dit si l'outil sera adopté ; la feuille de contrôle vous dit si le résultat peut être défendu. Un outil qui obtient une bonne note sans laisser de preuve a déplacé le coût de la relecture de l'analyste vers celui qui valide, ce qui est un vrai transfert de risque, pas une économie.
Comment exécuter le protocole de contrôle soi-même
Rien de tout cela n'exige la coopération d'un fournisseur. Le protocole s'applique à n'importe quel classeur, en un après-midi, avec le fichier déjà ouvert.
Choisissez cinq conditions, pas 99. Une identité de bilan par période, un report de solde, un test d'articulation, une comparaison de deux méthodes, une vérification du sens de variation. Cinq suffisent à distinguer un modèle d'un brouillon, et c'est assez court pour aller au bout.
Écrivez-les sous forme de formules dans une feuille séparée. Chaque ligne doit contenir les deux valeurs, l'écart et un témoin de validation. Un contrôle décrit en prose est un vœu ; un contrôle qui est une cellule est une preuve.
Indiquez la cellule sur laquelle s'appuie chaque contrôle. C'est l'étape que l'on saute, et c'est celle qui transforme un signal d'alerte en emplacement précis. Sans elle, un contrôle en échec vous dit que le modèle est faux, pas où.
Cassez le modèle exprès. Modifiez une variable motrice, vérifiez que les contrôles restent au vert, revenez en arrière. Si un contrôle bascule alors que rien n'aurait dû bouger, c'est le contrôle ou le lien qui est faux. Dans les deux cas, vous avez appris quelque chose que le fichier statique ne vous dirait pas.
Gardez la feuille dans le fichier que vous envoyez. Une feuille de contrôle restée dans votre copie de travail ne vaut plus rien dès que le fichier part sans elle. Celle qui voyage rend le modèle vérifiable par quiconque le reçoit.
C'est le même protocole que celui décrit dans les six types de contrôles, appliqué à l'outil qui a produit le fichier. Il est délibérément ennuyeux, et sa valeur tient à ce qu'il ne dépend pas de la confiance accordée à la personne qui l'a exécuté.
Ce que le classement signifie pour choisir un outil
Trois conclusions, par ordre de certitude.
La vitesse de production n'est plus un problème et ne fait plus la différence. Chaque outil du test publié a produit un modèle à trois états en une heure environ, et les deux premiers y sont parvenus en quinze minutes environ. Choisir en fonction de la vitesse, c'est choisir l'axe où l'écart est le plus faible.
La capacité de vérification n'est pas résolue et reste invisible dans les classements. Aucun outil du test publié n'a calculé les intérêts à partir des soldes qui les génèrent. Cette seule omission suffit à disqualifier un modèle à trois états : ce n'est plus un modèle à trois états, et elle n'a empêché aucun des quatre de se classer au milieu de la fourchette.
Le contrôle est à la portée de l'acheteur, pas seulement du fournisseur. Demandez la feuille de contrôle. Si l'outil ne peut pas en produire, le modèle reste un brouillon, quelle que soit son apparence, et les douze raccords prendront un après-midi à vérifier à la main. Voilà pourquoi il faut garder le modèle dans Excel plutôt que dans une boîte noire : la preuve voyage avec le fichier.
Pour la méthode derrière les chiffres, commencez par les six types de contrôles ; pour le seul modèle mené de bout en bout, le classeur à trois états ; pour le contrôle que tous les outils publiés ratent actuellement, la circularité des intérêts.
*Il s'agit ici d'une comparaison de résultats de tests publiés et d'une méthodologie, non d'un conseil en investissement. Aucun fournisseur n'a payé pour figurer ici, et les résultats rapportés ci-dessus sont cités d'après la source référencée.*
Dans Mica, les entrées restent distinctes des calculs ; la feuille de contrôle peut donc être réexécutée par l'acheteur, et pas seulement consultée.