
NPV、IRR 與 MIRR:三個指標,同一個問題
NPV、IRR 與 MIRR 用三種單位回答同一個問題。這裡同一組現金流給出 NPV 836、IRR 13.15%、MIRR 11.23%。三項模型輸出都指向接受;1.92 個百分點的差距是再投資假設,不是錯誤。
NPV、IRR 與 MIRR 回答的都是同一個問題:這個專案有沒有跨越它的資金成本。它們用三種不同的單位回答。
NPV 說這個專案用金額創造了多少價值。IRR 說這組現金流隱含的報酬率是多少。MIRR 說當你把再投資率明白說出來、而不是隱含假設時,隱含的報酬率是多少。三者一致時,決策很簡單,而一致本身告訴你現金流行為良好。三者不一致時,那個不一致就是關於現金流的線索。
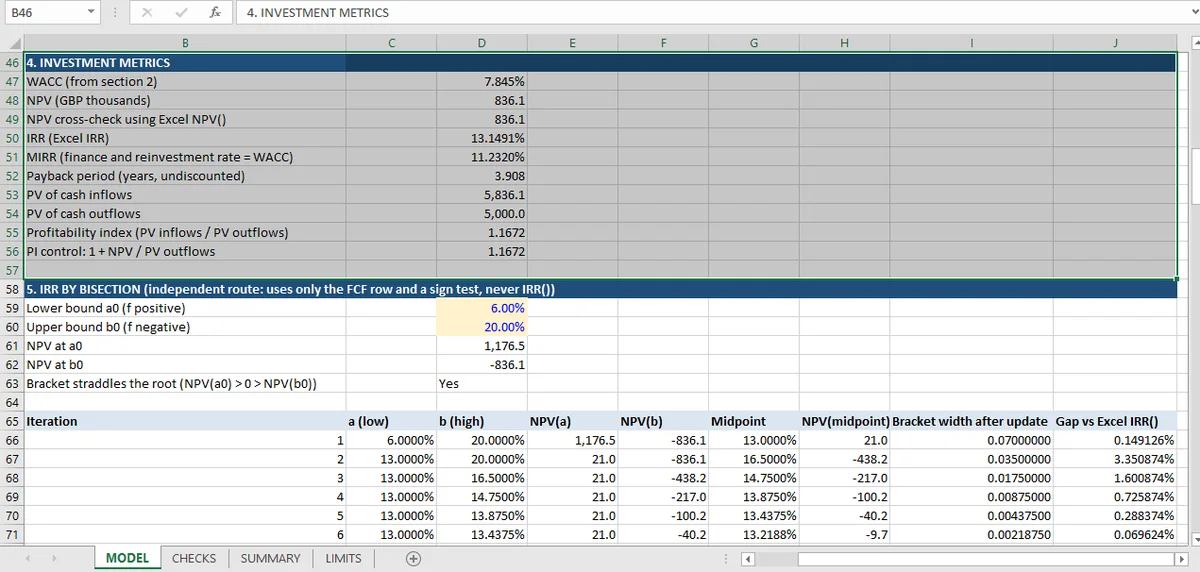
在本文所用的評估裡,它們在決策上一致、在數字上不一致:WACC 7.845% 下的 NPV 是 836,IRR 13.15%,MIRR 11.23%。三項模型輸出都指向接受。IRR 與 MIRR 之間 1.92 個百分點的差距,才是值得理解的部分。
NPV:另外兩個指標想逼近的數字
把自由現金流按資金成本折現再加總。計算就這麼簡單,而它是唯一不是報酬率的指標:它不依賴再投資假設,衡量的是錢,而不是一個會抬高小專案的比率。
基準情境是:第 0 年 −5,000,接著五年分別是 900、1,312.5、1,425、1,500、2,375。在 7.845% 下,現值合計 836。
兩條檢查從不同方向確認這個算術。第一條從折現後的現金流那一列重新加總;第二條對同一串數字呼叫 Excel 的 NPV() 函數。兩者相符到 2 × 10⁻¹³,這是雙精度算術的捨入雜訊,不是建模差異。第三條檢查做真正要緊的事:它在 IRR 本身重算 NPV,得到 8.08 × 10⁻⁸。那低於 10⁻⁷,而這正是 IRR 定義上該產生的結果。
NPV 該當領頭指標,因為它可以相加。兩個專案的 NPV 可以相加;兩個 IRR 不行。
IRR:假設以自己再投資的報酬率
內部報酬率是讓 NPV 為零的折現率。對這個專案是 13.15%,穩穩高於 7.845% 的資金成本。
埋在這個數字裡的假設是:每一筆期中現金流,都以 13.15% 再投資到專案結束。那不是預測,而是數學的性質。一家 WACC 7.845% 的公司,沒有理由相信自己能把第 3 年的 1,425,在剩下兩年裡以 13.15% 重新部署。
在這份評估裡,這個假設稍微美化了答案,因為 IRR 高於 WACC。對一個早期有大額流入、IRR 又高的專案,這種美化可能很可觀。這也是為什麼跨不同年限專案的 IRR 排名不可靠。
Excel 的 IRR() 還有第二個比較不明顯的特性:它從一個起始猜測值找出一個根。猜測值預設 10%,如果反覆運算不收斂,函數在 20 次嘗試後回傳 #NUM!,Microsoft 的文件 有說明。正負號變動超過一次的現金流序列,可能有不只一個正根,而 IRR() 會傳回它反覆運算剛好碰到的那一個。這個專案的序列恰好只有一次正負號變動,所以在這裡沒有歧義。但模型不假設如此,這就是為什麼 IRR 要解第二次。
把 IRR 解兩次
二分法區塊是任何評估模型都值得複製的檢查。它從固定的 6% 到 20% 區間開始,先確認區間跨越根,才開始反覆:6% 的 NPV 是 +1,176.51,20% 的 NPV 是 −836.05。
接著把區間對半切二十次。區間從 0.14 縮到 2.67 × 10⁻⁷,最後的中點是 13.149122%。Excel 的 IRR() 傳回 13.149126%。差距是 3.4 × 10⁻⁸,大約萬分之三個基點,而模型會檢查它低於 0.0001%。
這才是真正的收斂檢查:兩個演算法只共用現金流那一列,從不同方向抵達同一個數字。單一方法無法告訴你它是收斂了,還是停住了。
它背後的建構——一個只讀現金流那一列的獨立區塊,以及用具名利率而不是手打數字——就是Excel 財務應用指南 裡的做法。
MIRR:同一組現金流,加上明說的再投資率
MIRR 把再投資假設明白說出來,因此不再有隱藏假設。把每一筆流入按明說的利率複利到專案結束,把每一筆流出按同一個利率折現回起點,再解出讓兩者相等的單一利率。Excel 的 MIRR 函數 明確點名這兩個利率:你支付的融資利率,以及你收到的再投資利率。這就是這個指標的全部重點,因為假設不再被藏起來。
在這本活頁簿裡,兩個利率都設為 WACC 7.845%,得到 11.23%。模型沒有直接信任 Excel 的 MIRR():一條檢查會手工重建流入的未來值與流出的現值,再互相比較。
結果比 IRR 低 1.92 個百分點,方向正是理論預測的。以 7.845% 而不是 13.15% 再投資,會降低專案看起來賺到的報酬,因為早期現金流不再以自己的報酬率複利。
以 WACC 作為 MIRR 的再投資率是不是正確慣例,是另一個問題。把 WACC 同時當成融資利率與再投資利率,是慣例而不是預測,限制表也這樣說。一家真正相信自己能以更高利率再投資的公司,應該說出來並使用那個利率,讓假設在儲存格裡看得見。
NPV、IRR 與 MIRR 在哪裡分歧,以及該以哪個為準
真正會分歧的地方,是下行情境與融資型現金流。三者在這裡一致,讓排名問題變成假設性的。下行情境才是它變得具體的地方:營收低 10% 給出 NPV −277、IRR 6.03%、MIRR 6.62%。
NPV 是負的;IRR 6.03% 與 MIRR 都低於 7.845% 的資金成本。三項模型輸出都指向拒絕。排名一致,是因為這個專案只有一次正負號變動、現金流是常規的。
當 NPV 與 IRR 真正衝突時,幾乎總是兩種情況之一:專案的現金流屬於融資型(先流入、再流出),IRR 可能把決策規則整個反過來;或是兩個規模不同的專案,小的那個可以有較高 IRR、較低 NPV。兩種情況下,NPV 是規則,IRR 是描述,因為 NPV 衡量創造的價值,而問題就是價值有沒有被創造。
同樣的衝突在上一層也會出現,只是現金流從專案變成一整家公司:四種方法的評價 把同一份預測跑過 DCF、FCFE、股利與剩餘利益,得到跨度達中點 74% 的區間,原因相同。
MIRR 介於兩者之間:它保留人們容易比較的報酬率格式,又移除讓 IRR 誤導的假設。它沒有解決規模問題,也沒有取代 NPV。
檢查看不見什麼
六條檢查涵蓋這三個指標的收斂,而它們沒有一條能告訴你現金流對不對,或它們收斂到的根是否唯一。
第二個缺口值得講明。二分法與 IRR() 相符,前提是兩者收斂到同一個根;唯一性需要先數有幾個根,而這本活頁簿沒有做。另類投資主題 有:一組有三次正負號變動、一個正根的基金現金流,以及一組有兩個正根的比較序列,而 IRR() 會直接傳回它的猜測剛好碰到的那一個。
對這個專案,缺口是理論性的:序列是 −5,000 之後五筆正流,恰好一次正負號變動,所以依笛卡兒符號法則,恰好有一個正根。但模型從不斷言這件事,想要這個保證的讀者,得自己去檢查現金流那一列。
另一個缺口是折現率。IRR 13.15% 對上 WACC 7.845%,是 5.3 個百分點的緩衝,而這個緩衝值多少,完全取決於 7.845% 推導得多嚴謹。
檢查確立的範圍比上面任何一項都窄:每一項指標是從自己的定義算出來的、定義與現金流相符、IRR 的兩個演算法收斂。它們沒有確立 7.845% 是正確的資金成本(WACC 敏感度文章 就是拆解那個數字的地方),也沒有確立備忘錄的現金流是對的。想逐項重跑這六十七條檢查,可以從資本預算頁面 開始;如果你想先看兩條 IRR 路徑怎麼接起來,先讀建構視角。
每個指標都從自己的定義重算,這是 Mica 的做法;它報出的 IRR,因此可以在同一張工作表上對照第二條路徑。