
可比倍数:给估值提供市场锚的方法
可比倍数把估值锚定到市场当前愿意为类似企业付的价格。可比倍数分析应该报告一个分布:四分位数,而不是均值。这个估值工作簿完全没有同业组,本文讲的是它需要什么,以及有了之后怎么检查。
折现现金流告诉你,如果你的预测是对的,一家企业值多少。可比倍数告诉你,市场当前愿意为类似企业付多少。两者单独都不是答案,而一个没有市场交叉验证的估值,就是一份披着估值外衣的预测。
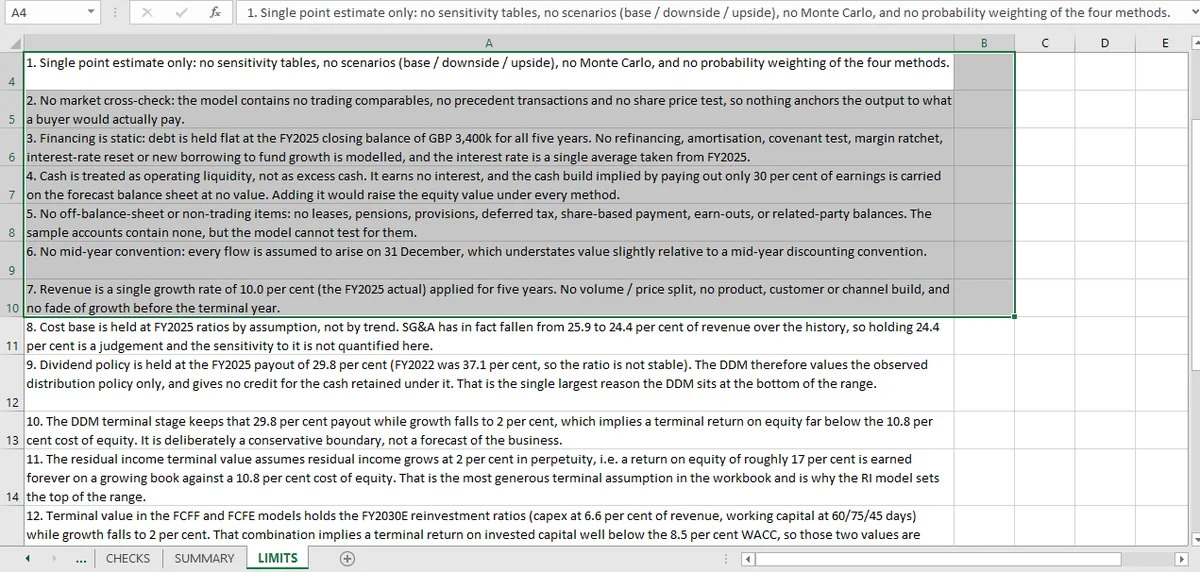
这个工作簿没有可比公司。它的限制表直接这么说:「没有交易可比公司、没有先例交易、没有股价测试,所以没有任何东西把输出锚定到买家实际愿意付的价格。」这是一个真实的缺口,本文讲什么能填上它,以及填上之后怎么检查。
一个倍数就是一个分布
取十二家可比公司,每家算 EV/EBITDA,你就有了十二个数字。报告它们的均值是估值里最常见的错误,因为倍数的分布是偏的,均值落在尾部。
有用的汇总,是把一组分位数(第 25、中位、第 75)乘到标的公司的指标上。这会产生一个区间,原因和四种 DCF 方法产生区间一样:输入不一致,而不一致就是信息。
三项检查让这件事站得住脚。
倍数在同业之间按同一口径计算。 企业价值指市值加净债务,每家公司使用相同的债务定义。一张表里,一家同业的 EV 包含租赁、另一家不包含,那不是分布,那是一个随机样本。
分母是同一期间。 基于前瞻盈利的 EV/EBITDA 和基于最近报告盈利的 EV/EBITDA 是不同的倍数,不能混在一起。表应该在一个单元格里说明用的是哪一个,每一行都应该引用它。
应用是对称的。 如果区间是 8.0× 到 11.0×,隐含价值就是标的指标分别乘以每个倍数,而中位数是隐含价值的中点,不是中位倍数的隐含价值。当指标为负时两者不同;只要分布偏斜,两者按定义就不同。
可比公司会给这个区间补上什么
这里的四种方法产生 7,080 到 15,439 的估值范围,区间跨度为中点的 74%。跨度大到区间本身就成了结论,而不是某个数字周围的置信区间。
可比公司分析会以一种特定方式收窄它:它会告诉你市场相信区间的哪一端。如果同业组按 9× EBITDA 交易,而标的的 FY2030E EBITDA 隐含接近 DCF 区间上端,市场就是在给乐观的终值假设定价。如果它隐含底端,市场就是在给保守的那个定价。
这个补充不小:它把「价值在 7,080 到 15,439 之间」变成「市场在 11,000,这与约 12% 的终值 ROE 一致」。第二句话只能作为分析比较,不是交易建议。
这个工作簿为什么没有可比公司,代价是什么
这个工作簿没有同业组,原因不是遗漏,而是标的公司根本不存在。给的资料是一家虚构公司四年的账目,没有行业、没有上市可比公司、没有交易数据。
拿真实公司搭一组可比公司、再套到虚构公司上,算出来的数字没有意义,工作簿也就变成在为一个本不该做的比较做算术检查。把它排除在外并说明原因,是正确做法。
它让读者失去的是锚。工作簿里的每个价值都是关于假设的陈述,没有一个是关于买家会付多少的陈述。想要那个的读者得自己提供同业组,而他们首先要检查的是,这些倍数是否在表里按同一口径计算。那项检查比 EBITDA 倍数变动 0.1 倍更有价值。
怎么搭一张可比公司倍数表
四列就够了:EV、指标、倍数,以及一条关于来源期间的注释。如果同业组口径混杂,再加第五列写债务定义。
然后在三个单元格里写明应用的区间(低、中位、高),并减去净债务,算出每个对应的隐含股权价值。唯一要紧的算术是:三个都用同一个指标,减掉的债务就是加进企业价值的那笔债务。
估值框架的其余部分,见估值页面;用来夹住区间的四种方法在区间一文 里拼装;下一个问题,倍数变动时会发生什么,在敏感性一篇 里。倍数要拿来对照的 DCF 价值,来自FCFF 与 FCFE 两条路径。
可比公司的缺席是可见的,而不是被埋起来:Mica 不会凭空造一组同业,它只呈现模型真正拥有的输入。