AI 搭建的 Excel 模型,看着已经做完,但账可能仍对不上
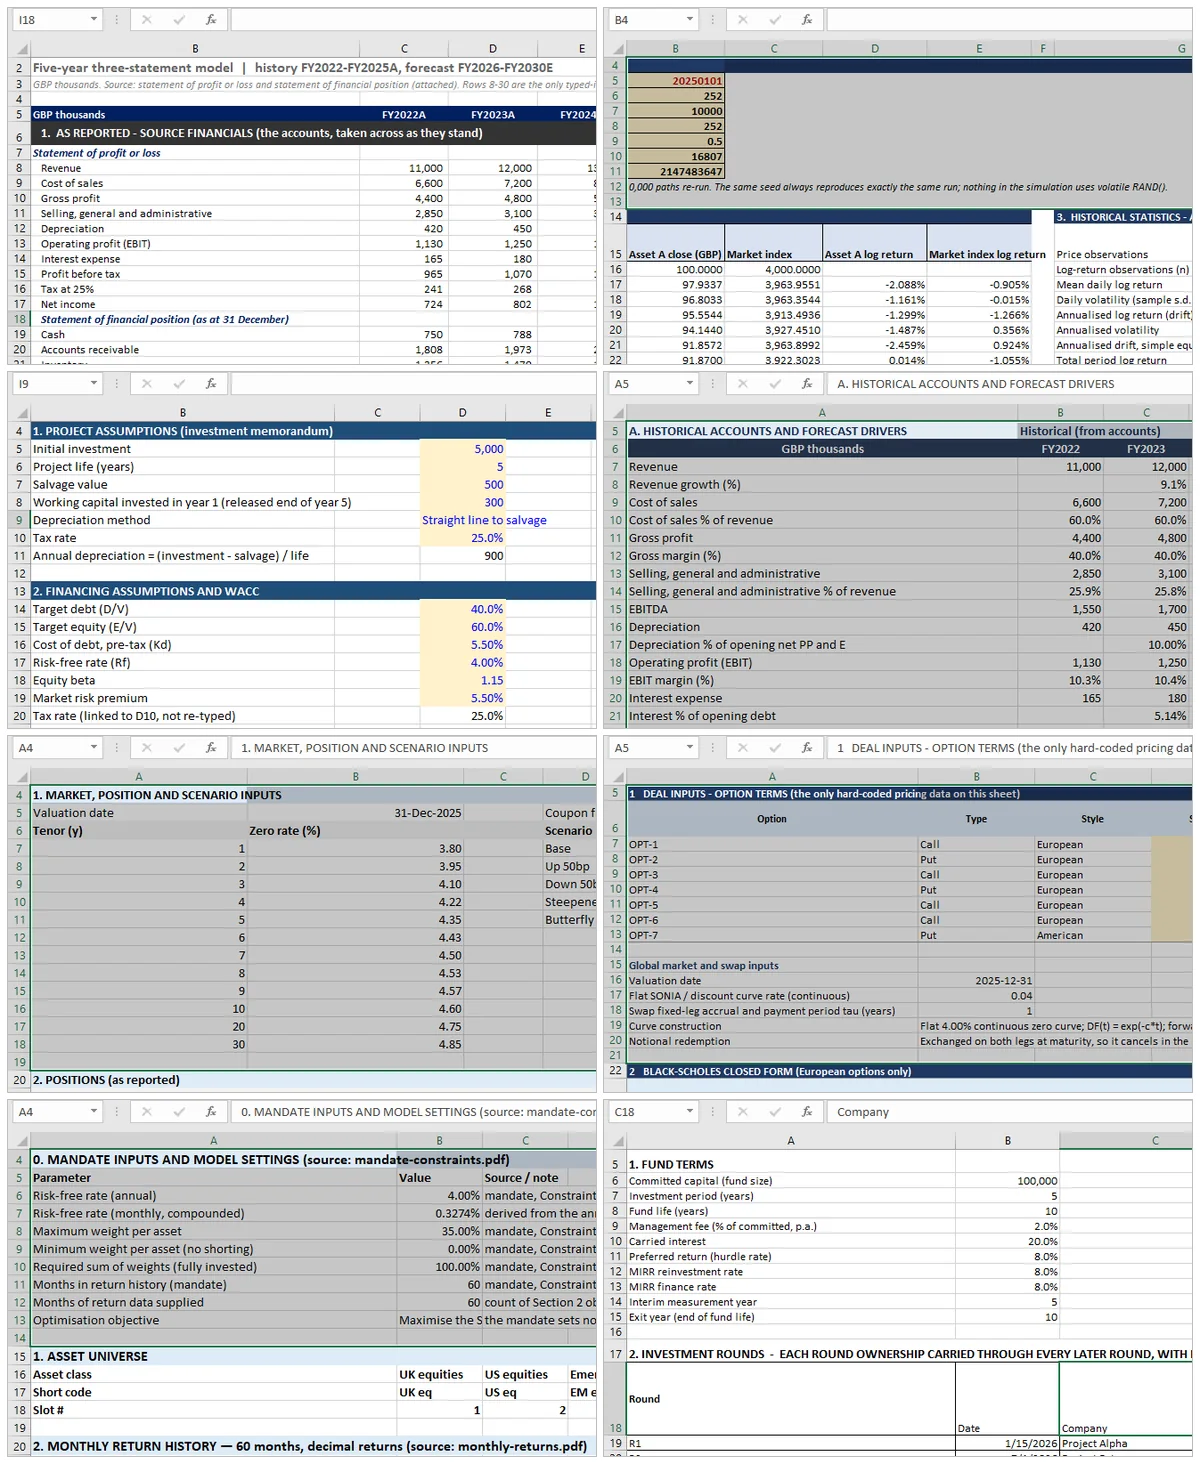
本系列案例的设置方式。 八个主题各自是一个独立的合成案例:一家有四年账目的公司、一份一页纸项目备忘录、一张条款表图片、一组七只债券的持仓、一条价格序列、一个六类资产组合,以及一只十年期基金。每一个都在 Excel 里从源文件搭出来,然后拿它跟自己对账。公司、基金和组合都是构造出来的;没有使用任何真实的客户文件,也没有任何外部市场价格来验证输出。检查测的是成品工作簿内部是否一致,不是输入对不对。这些是用于方法演示的合成案例;本页没有任何内容构成投资、税务或法律建议。
Excel 模型审计,就是对做完的工作簿跑六类检查。第一类看每个会计期间的会计恒等式是否成立;第二类看各期公式是否一致;第三类看优化器有没有满足自己设定的约束;第四类看两种方法能不能给出同一个数字;第五类看敏感性有没有朝正确方向变动;第六类看方法本身有哪些已知特性。本页用一个工作簿把这六类检查全部跑了一遍:99 项检查,全部通过。
AI 搭建出来的模型,刚打开时往往一切正常:格式对了,工作表也都命名了,公式都在,没有任何地方报错。然后你改一个假设,眼看着资产负债表不平了;或者点开利息那一格,发现本该放计算的地方放着一个常数。
问题出在结构,不在外观。工具能写公式,但它不知道自己已经满足了模型里的哪些约束。六类检查覆盖的就是这些约束。每一类都能在 Excel 里手工跑,适用于任何模型,不需要知道模型是怎么搭出来的。
为什么「打开不报错」不算检查
Excel 的错误值只能说明单个公式出了问题。#REF!、#DIV/0! 和 #VALUE! 都只说明某一个公式算不出来。它们都不会告诉你:折旧表是从错误的列复制过来的;税的正负号在历史期和预测期之间反了过来;或者某个本该放计算的位置被硬编码的数字占了。
一个模型可以完全没有错误值,却在每个会计期间都是错的。这不是小模型才会犯的错。一项独立基准测试让四款领先的 AI 工具各自为苹果公司搭一套三表模型。算术很少出错,出错的是各表之间的衔接:已公布的排名 记录显示,大多数工具“靠硬塞数字凑平,而不是做真正的表间衔接”,而且没有一款按计息余额来推算利息。
这类失败要靠检查来发现。检查不是审查代码,而是要求成品模型在表里、在每个会计期间都满足某个条件。
六类检查,以及每一类能抓住什么
| # | 检查类型 | 检查什么 | 能抓住什么(肉眼检查会漏掉) |
|---|---|---|---|
| 1 | 结构 | 每个会计期间恒等式成立 | 最后一列正确、中间某列却出错的明细表 |
| 2 | 一致性 | 每个会计期间的公式形状相同 | 藏在复制区域里的手工补丁 |
| 3 | 约束 | 结果满足模型自己声明的限制 | 优化器报出的最优解落在自己的约束之外 |
| 4 | 收敛 | 两种独立方法给出同一个数字 | 只有一种方法,无法自我审计 |
| 5 | 敏感性 | 输出朝正确方向、以合理幅度变动 | 一路错下去、却始终看不出破绽的模型 |
| 6 | 已知行为 | 识别方法本身的已知特性,而不是把它当成错误 | 正确的模型被判错,或错误的模型被判对 |
本页余下部分逐类展开,并说明少了这类检查,哪种错误就会漏掉。
检查类型 1:结构,即每一期的会计恒等式都必须成立
结构检查看的是会计恒等式:每一条在每一期都必须成立,不能只查最后一期。资产等于负债加所有者权益。期末留存收益等于期初留存收益加净利润减股利。资产负债表上的现金等于现金流量表上的期末现金。
这些恒等式
一个三表模型大约有十几条恒等式,几乎都是三种形式:总额等于各部分之和;期末余额等于期初余额加减变动;两张报表报出同一个数字。检查之前先把它们列成清单。诀窍就在这里:这份清单可以跨模型、跨期间反复使用。
大家记得最牢的,通常只有资产负债表恒等式。真正能抓住错误的,是滚动表、留存收益和固定资产,因为这里的差错会累积,而不是只出现一次。只要有一个会计期间把股利记错科目,之后每一期的留存收益都会跟着变,而资产负债表恒等式全程仍然成立,因为两边是一起动的。
AI 搭建的模型在这里容易错在哪
常见的错法有两种,都是结构性的。
第一种,总额不是加出来的,而是单独算出来的。工具在一列写 =SUM(C5:C12),在下一列敲一个数字,这等于没有满足任何要求;到底算不算真加总,要靠检查来证明。
第二种是调整项。资产负债表不平,最快的办法就是调一行,调到平为止。于是恒等式每个会计期间都通过,模型每个会计期间都错。结构检查还得再加一项:资产负债表两侧都要各自从来源重新搭一遍。下面的完整示例最终有 27 项检查,就是因为它要用第二条路径把报表重搭一遍。
检查类型 2:一致性,每个会计期间使用相同公式
一致性检查要找的是预测期中途变了写法的公式,手工补丁就藏在那里。
测试方法很机械:选中一行,一列列往右看,逐个比较。Excel 自带的 FORMULATEXT 能把任意单元格的公式当文本返回,这样一行十个期间就变成十个字符串,可以直接比对。九个单元格一致、第十个不同,这一行就被改过,不管是人改的还是模型改的。
一致性还管符号约定。比如一行在历史期为正、在预测期为负;或者一项所得税费用在一处是减、在另一处却是加。逐期恒等式能不能成立,要看符号约定;两段怎么接上,必须单独检查。三表工作簿对此做了明确检查:历史期的税项勾稽是净利润等于税前利润减所得税费用,预测期的勾稽是净利润等于税前利润加所得税费用。算术一样,符号相反,两段都得写清楚。否则符号约定一写反,五年的正负号就全反了,而且不会报错。
这一类还能抓住孤立单元格:没有任何东西引用它,它也不引用任何东西,通常是某个被放弃的做法留下的。它不影响任何数字,正因如此才躲得过人工审阅。
检查类型 3:约束,优化器必须满足自己设定的限制
约束检查要验证:模型返回的解,是否真的满足它自己声明的限制。
约束检查只适用于求解而不是计算的模型。以一个投资组合优化器为例:禁止卖空,单一资产上限 20%,权重之和必须为 1。它的解给出三条可检验的条件:没有负权重;没有权重超过上限;权重在容差内加总为 1。这些检验不关心最优解是怎么找到的,所以求解器被换掉也不影响。
同样的逻辑也适用于最优性条件。均值-方差解必须在给定的风险厌恶系数下满足自身的一阶条件,而这些条件可以用权重重新算出来。一旦重算结果与报告的最优解不一致,就说明求解器提前停了。这种失败,再怎么检查输入数据也发现不了。
检查类型 4:收敛,两种方法、一个数字
收敛检查是把同一个量分别用两种独立方法算一遍,再对比结果。单一方法没法审计自己。
正是这一类检查,把真正验证过的模型和只是看过一眼的模型区分开。两条路径,一个数字,一个差值,一个容差。
最清楚的例子是按平均余额计息,这本身就是个循环:利息取决于余额,余额又取决于利息。Excel 可以用迭代解出来,但迭代给出的数字看不出是怎么算出来的。审阅者看到一个数字,无法判断它是收敛了,还是撞到了迭代上限。用代数方法把循环解开、再算一遍同一笔利息,得到第二个不依赖循环算出的数,两者相减就是检查。下面的完整示例里,这类检查占 99 项中的 10 项,五个预测年度的最大差异是 5 × 10⁻¹³(单位:千)。
只要一个量有两种算法,就能套用同一套做法:用牛顿法和重定价循环分别求债券收益率,用公式和有限差分分别算久期,用期权价格验证买卖权平价关系。检查的价值完全在于第二条路径的独立性。
检查类型 5:敏感性,输出必须朝正确的方向变动
敏感性检查改动一个输入,验证输出朝正确的方向、以合理的幅度变动。
它能抓住所有勾稽都抓不到的问题:一个错得很顺、却始终一致的模型。折现率一提高,估值反而上升,只可能有两个原因:公式符号反了,或者引用方向错了。这两样在静态表里都看不出来。同一条测试还能抓住另一种敏感性表:某一行是按错的轴算的,乍看没问题,细看才发现它不单调。
幅度和方向同样重要。WACC 动一个百分点,估值就变 40%。这要么是估值对折现率的敏感度算错了,要么是估值几乎全靠终值撑着。哪些幅度算合理,得靠人判断,所以这项检查给的是一段区间,不是一条及格线。
检查类型 6:已知行为,识别方法本身的已知特性
有些检查失败,是因为方法本身有已知特性,而不是模型错了;在输出里,这两种情况看起来一模一样。
IRR 与多重解
一条现金流序列如果有不止一次符号变化,就可能有不只一个内部收益率。Excel 的 IRR 从一个给定的初值出发,返回它找到的第一个根。两个分析师用不同初值,可能从同一条序列解出两个都算得通的 IRR,其中一个在经济上毫无意义。
检查要问的不是「IRR 对不对」,而是「这条序列有几个根,报出来的是哪一个」。基金现金流先有一笔流出,中间很长一段为正,最后来一次资本催缴,就是标准情形。
循环引用
Excel 默认把循环引用当成错误;一旦打开迭代计算,就不再把它当错误。设置项是「最多迭代次数」和「最大更改量」,默认分别为 100 和 0.001,Microsoft 的文档 写得很清楚。在这些设置内收敛的循环没有问题;不收敛的循环则完全不报错,只会产生一个每次重算都会变的数字。
所以检查必须写成行为测试,而不是错误测试:强制完整重算两次,确认数值相同。财务模型中的循环引用 一文讲了解决这个循环的三种办法,以及每种在可审计性上要付的代价。
模型验证完整示例:一个工作簿,99 项检查
完整示例就是一个工作簿、99 项检查,全部通过。这套方法说起来容易,演示起来难,所以我们把模型从头到尾跑了一遍,连同检查表一起公开。目前有两篇写了完整报告;其余的已经跑过,排队等写。
输入是两份 PDF,分别是一家虚构公司四年的损益表和资产负债表。任务说明要求搭一个五年期三表模型:用这两张表重建现金流量表,资产负债表每年都平,利息按平均现金余额计提并计算两次,另外用一组独立列重建资产负债表。答案直到建模完成后才公布。
| 检查类别 | 检查数 | 通过数 |
|---|---|---|
| 资产负债表恒等式 | 9 | 9 |
| 按报表口径的总额 | 8 | 8 |
| 损益表算术 | 21 | 21 |
| 现金流量表衔接 | 8 | 8 |
| 滚动表 | 16 | 16 |
| 利息:迭代法与代数法 | 10 | 10 |
| 第二条路径:恒等式与吻合度 | 27 | 27 |
| 合计 | 99 | 99 |
99 项检查全部通过,可 FY2030 的期末现金是 −1,113,因为模型里没有任何融资安排来填这个缺口。这才是本页最有价值的信息:它说明检查覆盖了什么、又漏了什么。三张报表衔接上了,但计划本身并不存在。三表检查 正在逐篇发布,从十二项勾稽开始。
100% 通过只能说明前后一致,说明不了准确。每项检查比较的都是模型和同一个建模过程产出的另一个结果;没有任何一项拿源 PDF 跟录入的数字对照。通过数只是下限,不是成绩。
同样的六类检查适用于全部八个模型。八个模型都已经跑过,每一篇都会随成稿一起公开它的模型、检查表和限制表:
这一节的真实状态就是这样:两个模型从头到尾写完,六个已跑完、排队等写。方法本身只是一个主张,检查表才是证据,而证据只能靠一个个模型慢慢积累。
这些检查背后的 Excel 操作,可以对照工作簿 Agent 指南 一起看;Mica 指南 讲建模是怎么在文件里一步步执行的,DCF 实操 则是完整的现金流示例。
公开的工具排名到底测了什么、漏了什么,见对比文章:它讲的是快速草稿与可验证模型之间的差距。
本系列里的每个模型都用 Mica 搭建;它在工作簿里执行每一步,每一次改动都精确落到具体单元格,因此 AI 搭出来的模型可以重跑、逐行检查。