
NPV、IRR 与 MIRR:三个指标,一个问题
NPV、IRR 和 MIRR 用三种口径回答同一个问题。这里同一组现金流给出 NPV 836、IRR 13.15% 和 MIRR 11.23%。三个模型的输出都指向接受;1.92 个百分点的差距是再投资假设,不是错误。
NPV、IRR 和 MIRR 回答的都是同一个问题:这个项目的回报有没有高于资本成本。它们用三种不同的口径来回答。
NPV 说项目用金额创造了多少价值。IRR 说这组现金流隐含什么回报率。MIRR 则是把再投资率明确写出来、不再暗中假设之后,这组现金流的隐含回报率。三者一致时,决策很容易,一致本身也告诉你现金流形态良好。三者不一致时,这种不一致是关于现金流的信号。
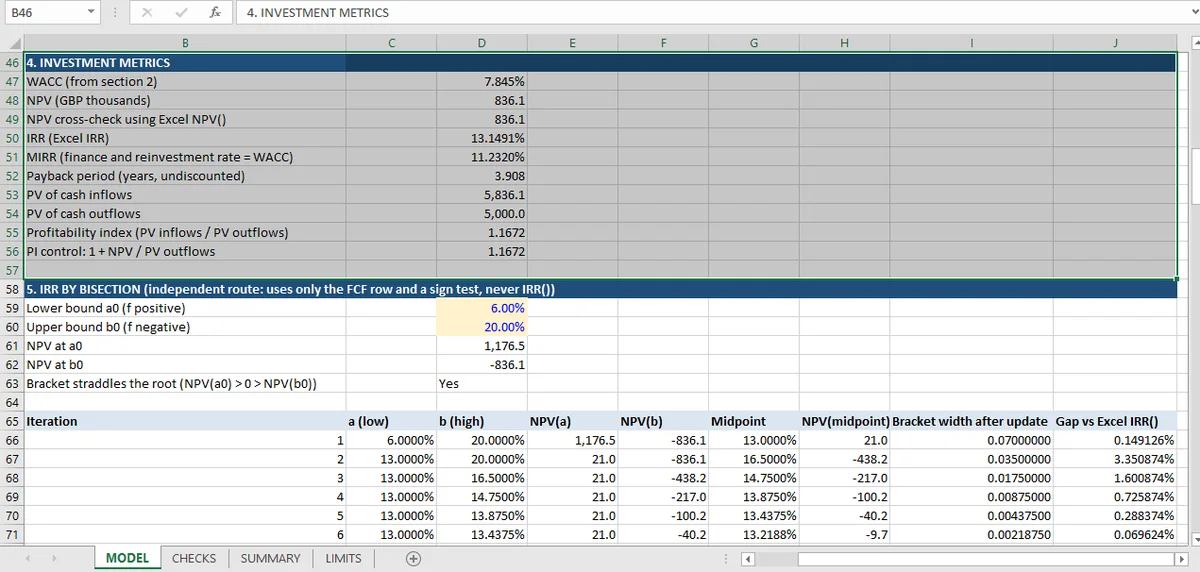
本文背后的评估里,它们在决策上一致,在数字上不一致:7.845% WACC 下 NPV 为 836,IRR 为 13.15%,MIRR 为 11.23%。三个模型的输出都指向接受。IRR 与 MIRR 之间 1.92 个百分点的差距,才是值得弄懂的部分。
NPV:另外两个想逼近的那个数字
按资本成本把自由现金流折现再加总,计算就这么多;它也是唯一一个不用利率表示的指标:不依赖再投资假设,衡量的是这笔钱值多少,而不是一个可能抬高小项目的比率。
基准情形是:第 0 年 −5,000,随后五年依次为 900、1,312.5、1,425、1,500 和 2,375。按 7.845% 折现,现值合计 836。
两项检查从不同方向确认这个算术。第一项从折现后的现金流那一行重新加总;第二项对同一序列调用 Excel 的 NPV() 函数。两者一致到 2 × 10⁻¹³,这是浮点运算的舍入误差,不是建模差异。第三项检查做真正要紧的事:它在 IRR 本身重算 NPV,得到 8.08 × 10⁻⁸。这低于 10⁻⁷,而按 IRR 的定义,结果就该如此。
NPV 应该是主指标,因为它可加。两个项目的 NPV 可以相加;两个 IRR 不能。
IRR:一个假定按自身再投资的利率
内部收益率是让 NPV 为零的折现率。对这个项目来说,它是 13.15%,明显高于 7.845% 的资本成本。
这个数字里埋着的假设是:每一笔期中现金流都按 13.15% 再投资,直到项目结束。这不是预测,而是数学本身的性质。一家加权平均资本成本为 7.845% 的公司,没有理由相信自己能把第 3 年的 1,425 在剩下两年里按 13.15% 再投资。
在这份评估里,这个假设略微高估了回报,因为 IRR 高于 WACC。对一个早期有大额流入、IRR 又高的项目,这种高估可能相当可观。这也是不同寿命项目的 IRR 排名不可靠的原因之一。
Excel 的 IRR() 还有一个不太引人注意的特点:它从初值出发,只找一个根。初值默认为 10%,如果迭代不收敛,函数在 20 次尝试后返回 #NUM!,Microsoft 的文档 是这么写的。符号变化不止一次的现金流序列,可能有不止一个正根,而 IRR() 会返回它迭代过程中碰巧找到的那一个。这个项目的序列恰好只有一次符号变化,所以这里没有歧义。但模型并不假设这一点,这就是 IRR 要解第二遍的原因。
把 IRR 解两遍
二分区块是值得照搬进任何评估模型的检查。它从固定的 6% 到 20% 区间开始,并在迭代前确认区间包住根:6% 时 NPV 为 +1,176.51,20% 时为 −836.05。
然后把区间对半切 20 次。区间从 0.14 收窄到 2.67 × 10⁻⁷,最终中点是 13.149122%。Excel 的 IRR() 返回 13.149126%。差距是 3.4 × 10⁻⁸,约一个基点的万分之三,而模型会检查这个差距小于 0.0001%。
这正是收敛检查该有的样子:两种算法只共享现金流那一行,从不同方向到达同一个数字。单一方法无法告诉你它是收敛了,还是停住了。
它背后的搭建方式,也就是一个只读现金流那一行的单独区块,以及一个命名利率而不是敲进去的利率,就是面向财务的 Excel 指南 里的模式。
MIRR:同一组现金流,一个明说的再投资率
MIRR 通过把再投资率明说出来,移除了这个假设。按给定利率把每一笔流入复利到项目结束,按同一利率把每一笔流出折现回起点,再解出使两者相等的单一利率。Excel 的 MIRR 函数 把这两个利率明确命名:你支付的融资利率,和你收到的再投资利率。这就是这个指标的全部意义:假设不再藏着。
在这个工作簿里,两个利率都设为 WACC,即 7.845%,得到 11.23%。模型并不信任 Excel 的 MIRR():一项检查手工重建流入的未来值和流出的现值,再作比较。
结果比 IRR 低 1.92 个百分点,方向也符合理论预期。按 7.845% 而不是 13.15% 再投资,会降低项目表面赚到的回报,因为早期现金流不再按自己的利率复利。
按 WACC 计算 MIRR 是不是正确约定,是另一个问题。把 WACC 同时当作融资利率和再投资利率,是一种约定而不是预测,限制表也这么说。一家真正相信自己能以更高利率再投资的公司,就应该明说,并使用那个利率,把假设放在一个看得见的单元格里。
NPV、IRR 与 MIRR 在哪里分歧,该跟哪个走
三者在本案例里一致;真正的分歧出现在现金流形态或项目规模不同时,决策应以 NPV 为准。三者在这里一致,所以排名问题只是假设性的。悲观情景才让它具体起来:收入低 10%,给出 NPV −277、IRR 6.03%、MIRR 6.62%。
NPV 为负;6.03% 的 IRR 和 MIRR 都低于 7.845% 的资本成本。三个模型的输出都指向拒绝。排名一致,是因为项目只有一次符号变化、现金流是常规现金流。
NPV 与 IRR 真正冲突时,几乎总是两种情况之一:项目的现金流是融资型(先流入,再流出),此时 IRR 可能把决策规则整个反过来;或者两个项目规模不同,小的那个可能 IRR 更高而 NPV 更低。两种情况下,NPV 是规则,IRR 是描述,因为 NPV 衡量创造的价值,而问题正是价值有没有被创造。
把现金流从项目换成一家公司,同样的冲突也会出现在上一层:四种方法的估值 把同一份预测依次用 DCF、FCFE、股利法和剩余收益法来估,得到 74% 宽的区间,原因相同。
MIRR 夹在两者之间:它保留了人们容易比较的利率形式,又移除了让 IRR 误导的那个假设。它不解决规模问题,也不取代 NPV。
检查看不见什么
六项检查覆盖这三个指标的收敛性,但没有一项能告诉你现金流是否正确,或者它们收敛到的根是不是唯一的。
第二个缺口值得说清楚。二分法与 IRR() 的一致,以两者收敛到同一个根为条件;唯一性需要数清根的个数,而这个工作簿没有做。另类投资主题 做了:一组基金现金流有三次符号变化、一个正根,另一组比较序列有两个正根,IRR() 会悄悄返回初值碰巧找到的那个根。
对这个项目来说,这个缺口是理论上的:序列是 −5,000 后面跟五笔正流入,恰好一次符号变化,所以按笛卡尔符号法则恰好有一个正根。但模型从未断言这一点,想要这个保证的读者得自己去检查现金流那一行。
另一个缺口是折现率。13.15% 的 IRR 对 7.845% 的 WACC,是 5.3 个百分点的余量,而这个余量值多少,完全取决于 7.845% 算得有多好。
检查确立的东西比这些都窄:每个指标都按自己的定义算出来,定义与现金流一致,IRR 的两种算法也收敛。它们不确立 7.845% 是正确的资本成本(WACC 敏感性一文 就是拆解这个数字的地方),也不确立备忘录的现金流是对的。想逐项跑完这个工作簿的 67 项检查,从资本预算页面 开始;如果你想先看两条 IRR 路径怎么接起来,先读搭建视角。
每个指标都按自己的定义重算,报出的 IRR 才能在同一张表里对着第二条路径检查;在 Mica 里,这两条路径始终并排。