
自检是搭建的属性,不是复核的属性
一个能自我检查的模型需要五条搭建规则:每个驱动项一个单元格、公式里不敲数字、每行一种公式形状、一张读取模型的检查表,以及一张限制表。它们合起来,让 99 条检查在工作簿每次重算时都跑一遍。
大多数模型是在搭好之后由人读公式、比总额来检查。能自我检查的模型是在搭建过程中被检查的,因为检查是工作簿的一部分,每次重算都会跑。
区别是结构性的。只写在复核文档里的检查,记录的是某人在某一天对这个模型的想法;写进单元格的检查,反映的是模型现在的样子,包括之后做出的每一次改动。这就是为什么本系列工作簿里的 99 项检查是公式而不是结论,以及为什么摘要表用 COUNTIF 统计它们,而不是直接写出合计数。
五条搭建规则让这一切成为可能。这五条没有一条多高明,而且每一条在赶时间时都很容易被跳过。AI 工具搭的模型,往往就会跳过它们。
让检查成为可能的搭建规则
规则 1:每个驱动项一个单元格
每一个会推动预测的假设都有自己的命名单元格,工作簿里没有别的地方包含那个数字。
在三表搭建里,这就是为什么 40%、60、75、45、6.59%、10.49% 和 6.16% 各只出现一次,而不是被敲进公式里。它还顺带让模型有了敏感性:动一个单元格,整个预测就动,不用编辑任何东西。
这条规则还有第二个不那么明显的作用。命名驱动项是唯一能区分输入和输出的地方。当审阅者问一个数字来自账目还是来自模型时,假设区从结构上就回答了这个问题。
规则 2:公式里不敲数字
这是人们最先打破的规则,因为像 =C10*1.4 这样的公式,比 =C10*(1+growth) 好写。
它要紧,是因为敲进去的数字对每一项不专门找它的检查都是不可见的。勾稽仍然成立,滚动表仍然滚动,而那个本该被链接的单元格现在是一个常数,假设变化时它不会动。建模指令本身就写明了这条规则(「任何本该是公式的数字都不要硬编码」),而检查表就是用来证明这条规则被遵守的。
FORMULATEXT 是成本最低的测试:它能把任意单元格的公式作为字符串返回,所以扫一遍公式里的数字字面量,几秒钟就能找到例外。
规则 3:一个期间,一种公式形状
把公式复制过去,绝不逐列敲。一行里最后一格和前面九格不同,这一行就是有人改过,而模型没法告诉你这次改动是有意的修正,还是一个补丁。
正是这条规则让一致性检查成为可能:拿一行里的十个公式来比对,只有在其中九个本来就该完全相同时才有意义。
规则 4:一张读取模型的检查表
检查属于工作簿,一条检查一行,并在某一列点名它测试的模型单元格。
三表搭建里,每项检查一行,带一个 ID、一句描述、一个期间、一个状态、被比较的两个值、差值,以及被读取的单元格:99 行,容差 0.01,状态由差值算出而不是敲进去。因为每一行都点名了自己的单元格,任何失败的检查都能直接指向弄坏它的那个数字,任何通过的检查都能点进去核验。
规则 5:一张限制表
检查证明什么成立。限制表说明什么从未被测试。
这个工作簿里有 18 条,其中三条有实质影响:融资缺口、缺失的 FY2022 期初余额,以及对债务和现金用同一个混合利率。没有这些条目,读者就有权假定模型覆盖了它悄悄没有覆盖的东西。
第二条路径,以及「独立」必须意味着什么
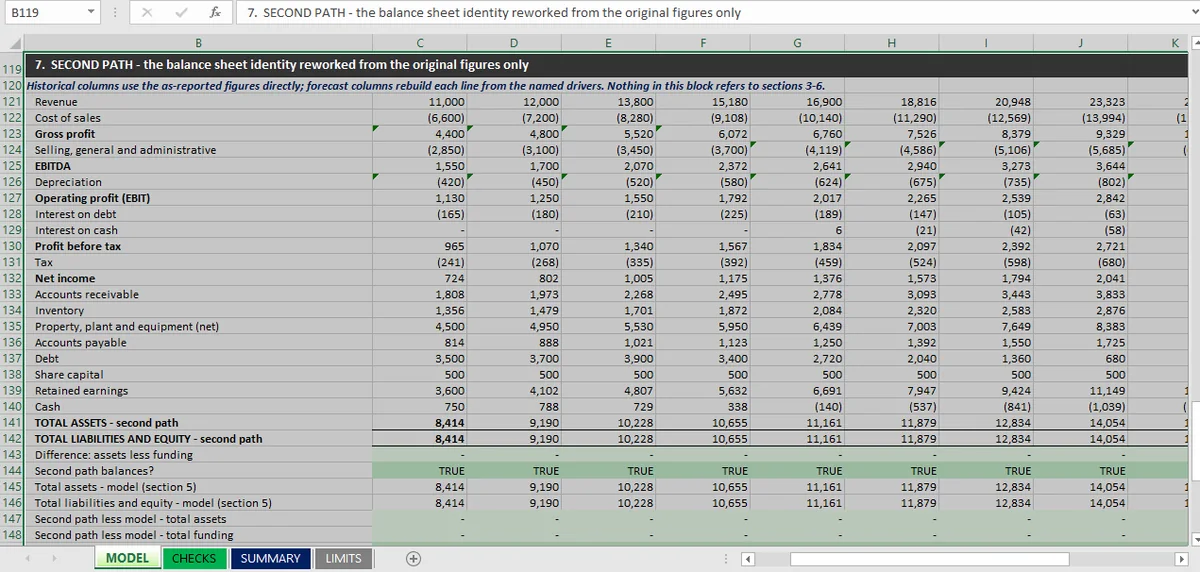
工作簿里最强的检查,并不是对模型本身下判断。它其实就是把同一张资产负债表单独搭第二遍,再拿模型去跟它比。
99 项检查里有 27 项在那里。九项验证第二条路径能否自己配平;18 项验证它在全部九年里逐年、逐行与模型一致。
要让这有意义,「独立」就必须有具体的含义:第二条路径可以读取原始报表数字和命名驱动项,别的什么都不行。它不能读取模型里的明细表、小计或中间计算。如果它读取模型的期末现金来检查模型的期末现金,那只是自己检查自己,多摆了几列而已。
这个区别可以测试。问第二条路径里的某个单元格,在模型的预测区域被删掉之后会怎样:如果它照样算得出来,这条路径就是独立的;如果它报错或返回零,它就从来不是独立的。Microsoft 的追踪引用单元格 用可视的方式回答这个问题,一次一层。
这个限制同样是结构性的,工作簿也说了。两条路径都由同一个搭建者、依据同一批驱动项搭成。所以这项比较只在驱动项正确的前提下成立:两条路径共用一个错误的驱动项时,它查不出来。这就是为什么第二条路径检查的是算术,而不是假设。
审阅者应该怎么读一个能自我检查的模型
一个能自我检查的工作簿分三遍读,搭建时必须按这个阅读顺序来安排,而不是图作者方便。
第一遍,看头部:模型说了什么,用四五个数字,放在一张不是预测表的表上。收入、净利润、期末现金,以及检查过不过。在这里的工作簿里,那就是 SUMMARY 的最上面,也是发现所在的地方——现金 −1,113,而不是埋在 K 列里。
第二遍,看检查:有多少项、哪几类、什么失败了。信任检查的审阅者不需要模型;不信任的审阅者会打开 CHECKS 挑一行。
第三遍,看限制:模型不做什么。这是大多数读者会跳过的一遍,也是改变前两遍读法的一遍。99 项通过,加上 18 条写明的限制,才诚实地描述了一个模型。99 项通过却没有限制表,描述的只是一个说法。
顺序要紧,因为审阅者在第一遍形成看法,然后用剩下的时间确认它。把发现放在读者一打开就能看到的地方,这样的文件才会被正确阅读。
这样搭建的代价
三样代价,按痛感排序。
时间。 第二条路径花的时间和模型一样长。它是对资产负债表九年数据的第二份搭建,存在的唯一目的就是拿来跟第一份比。
占用的空间。 四张表而不是一张,检查表比它检查的大多数明细表还长。一个证据占的地方比预测还大的模型,不常见,但正确。
对某一类特定读者的可读性。 想看到预测的人可以在 MODEL 里看到。想知道它怎么被验证的人得去读 CHECKS,而那是另一种技能,不同于读预测。
换来的只有一件事:任何人都能在半分钟内重新检查这个模型,不需要信任搭它的人。这就是整个主张,而且值得把替代方案说得很直白。一个无法复查的模型,就只能靠当初碰巧有空的那个人检查那一次。
什么时候不该这样搭
不是每个模型都值得配第二条路径。一张五行科目的一页纸预测,读一遍就能检查,再加上 99 项检查,只会变成没人看的开销。
经验法则是「错了会怎样」。如果模型辅助的本来就是一个靠判断的决定,一张勾稽表就够了。如果它会被一个没有参与搭建的人依赖(贷款人、董事会、审计师,或者买了它的客户),那么有没有第二条路径和限制表,就是成稿与草稿的区别。
Mica 在已经打开的工作簿内部搭建,编辑的是 Windows 上已经在 Excel 里打开的 .xlsx;它加的每一条公式都会先出现在工作表里,等你接受。正是这种可见性,让搭建规则真的能执行:看不见的检查就没法核验,没法核验的模型就只能选择相信。
检查本身在十二项勾稽 里说明,它们给下一个人留下的证据在审计痕迹 里,把它们摆到读者面前的方法在Excel 模型审计 里。这个工作簿的完整结果,见三表页面。