
一次回归的三个数字
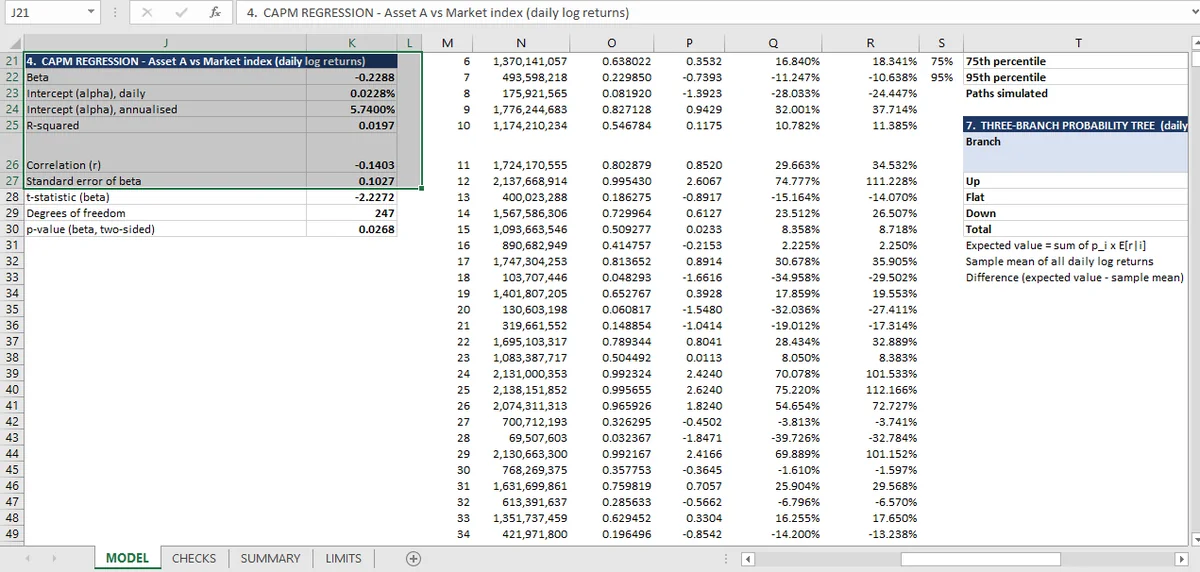
beta 为 −0.229、p 值 0.0268,在 5% 水平统计显著。R² 是 0.0197,所以市场解释了 2% 的变异。两个数字都被报告,合起来说明这个关系真实但几乎无用。
工作簿把一项资产的日对数收益率对市场指数做回归,报告三个数字:
| 统计量 | 数值 |
|---|---|
| Beta | −0.229 |
| p 值 | 0.0268 |
| R² | 0.0197 |
每个都被检查,而检查值得理解,因为它们指向不同方向。
beta 恒等式
Beta 可以用两种方式计算:作为回归的斜率,或作为相关系数乘两个波动率之比。
两条路径在这里一致到小数点后第十三位。这是对实现的检查,不是对经济含义的检查:它确认回归斜率和相关系数是从同一条序列、用同样的均值和同样的分母算出来的。
如果比如回归用简单收益率、而相关系数用对数收益率,它就会失败。这种不匹配会产生一个看起来合理、却错几个百分点的 beta。
R² 就是相关系数的平方
第二个恒等式:R² 等于相关系数的平方。两者都是 0.0197。
三个数字从这里开始讲故事。R² 0.0197 意味着指数解释了这项资产收益率变异的 2%。另外 98% 不在这个回归里,这让它成为一个数据分析问题,而不是公式问题。
p 值,以及它是关于什么的 p 值
p 值 0.0268 说的是:如果真实 beta 为零,249 个观测的样本大约有 2.7% 的时间会产生至少这么大的斜率。对 249 个观测,这对应大约 2.2 的 t 统计量。
由此有三件事,而它们并不都指向同一个方向。
符号可靠。 p 值 0.027 低于惯常的 5% 门槛,所以负关系不太可能是这个特定样本的产物。
幅度不可靠。 以 −0.229、t = 2.2 的 beta 为中心的 95% 置信区间,大约从 −0.43 到 −0.03。这个范围既包括「没有有用的对冲」,也包括「相当大的空头敞口」。
解释力可以忽略。 R² 0.0197 正是让显著性不令人意外的原因:有 249 个观测,几乎任何非零关系都会显著。显著性回答「它存在吗」;R² 回答「它要紧吗」。
模型跑的那项检查很宽松(p 值落在 [0,1]),它是对转录错误的检查,而不是统计主张。p 值 1.7 会是公式错误;0.0268 是合理的。
为什么检查表解决不了这件事
检查确认回归从序列正确计算。它们无法告诉你这个回归值不值得跑。
那个判断取决于 beta 用来做什么。对一个对冲比率来说,beta −0.229 配 2% 的 R² 几乎没用:对冲只会抵消 2% 的方差,还加上自己的风险。作为更大模型里的因子敞口,它可能正是需要的输入,同时把 R² 一并报告,让读者知道该给它多少权重。
工作簿把两者相邻报告,这是正确的结构。一张只显示系数和星号、却藏起 R² 的回归表,是用准确数字误导读者最可靠的方式。
什么能强化这个回归
三件事,都不在工作簿里。
一个标准误。 p 值隐含一个 t 统计量,但标准误没有给出来,而它是读者构造区间所需要的数字。
第二个样本。 这里每个统计量都用全部 249 个观测。一个拆分(前 150 个拟合,后 99 个测试)会显示关系是否持续,这是样本外问题 的最简形式。
对残差的正态性检查。 p 值假设残差正态。日收益率出了名地不服从正态分布,而 p 值是对这个假设最敏感的数字。
使用同一条序列的模拟是蒙特卡洛一文,全部 31 项检查连同结果,都在量化页面。这两个统计量来自的那条序列在收益与时间价值 里,假设正态收益率的模拟在概率树 里。
beta 可以与相关系数乘波动率之比比较,因为回归输出就放在检查它的恒等式旁边;Mica 让两者相邻。