
前三项检查是关于文件的
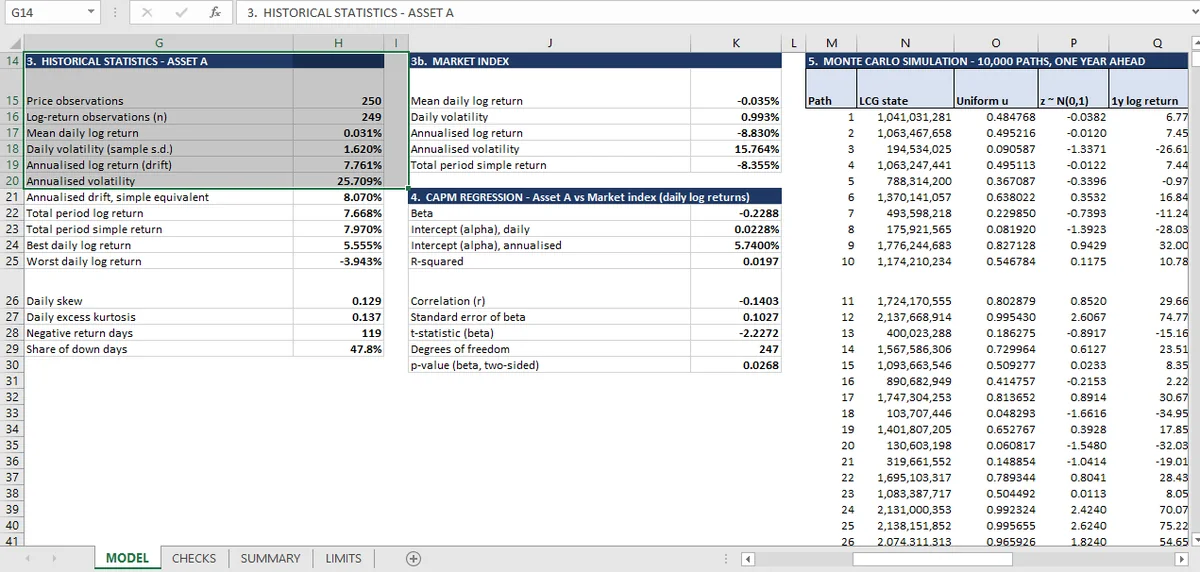
年化波动率是日标准差乘以交易年度的平方根:249 个收益率上为 25.71%。对数漂移是 7.76%。解析对数正态均值是 11.70%,而模拟的简单收益率均值是 12.03%,因为对数正态的均值高于它的对数均值。
在计算任何统计量之前,价格序列必须满足三件事:收益率个数比价格个数少一个、没有收盘价为零或负、日期严格递增。
这三项检查看起来不起眼;它们是会不报错却污染下游一切的那种失败,也是清洗收益率序列 的第一步。
漏掉一行会改变收益率个数,以及每一个基于个数的统计量。一个本该有 250 个价格、实际只有 249 个的序列,产生 248 个收益率,而从中算出的年化波动率是一个看起来没问题的数字。
零价格会产生无穷大的对数收益率。Excel 会在那个单元格显示 #NUM!,但如果随后用会忽略错误的函数(如 AGGREGATE(1,6,…))求平均,平均值就会悄悄按其余部分算出来。检查没有价格为零或负,是防范一整类不可见损坏的最便宜办法。
日期乱序会产生跨越错误区间的收益率:从周五到周三,再从周二到周四。没有任何东西报错。在乱序行上计算的对数收益率仍然加总为总收益,这就是这个错误如此难以看出的原因。
三项检查在这里都通过:从 250 个价格得到 249 个收益率、零个非正收盘、零个顺序违反。
250 个收盘价是从一份 PDF 价格文件读出来的,有些页面需要不止一遍 OCR。数据检查抓住漏行、零价格和乱序日期;它们抓不住一个被读成 8 而不是 6 的数字。那个错误会改变下游每个统计量;数据检查是结构性的,转录在它们的范围之外。
波动率恒等式
第一个真正的统计量是年化波动率:25.71%。
这项检查是恒等式,不是拿外部数字来对照:年化波动率必须等于日标准差乘一年交易天数的平方根。如果模型硬编码一个数字,或者用 365 而不是交易日历,或者在简单收益率而不是对数收益率上算标准差,恒等式就会失败。
这就是恒等式检查在单条序列上有用的原因。没有外部来源可以拿来对照 25.71%,但有一个定义,而模型必须满足它。
漂移,以及两个均值之间的差别
年化对数漂移是 7.76%。工作簿里出现两个均值,它们不是同一个数字。
对数收益率的算术均值是进入模拟的漂移参数。它是 0.0776。
简单收益率的均值更高:模拟里是 12.03%,对照解析对数正态均值 11.70%。对数正态的均值,等于对数均值的指数乘以 e 的半个方差次方,所以更高。这个关系本身就是一项检查。
只说「平均收益」而不说哪个均值,是量化写作里最常见的错误之一,而在一项年回报 8% 的资产上,这个差距是每年 4 个百分点。
这些收益率与时间价值检查为什么短
这篇文章短,是因为这些检查本身很短。三项文件完整性测试和四项恒等式不需要长篇辩护;它们需要被跑。
它们确立的是:其余一切的输入是一条干净序列,三个基本统计量按定义计算。它们不确立的是:这条序列是一个好样本。249 天就是一年、一种状态、一项资产。
消费这些数字的模拟是蒙特卡洛一文;使用同一条序列的回归是beta 一篇;量化页面 收了完整的 31 项检查表。同一条序列的两分支版本在概率树 里,它之上的组合层在有效前沿 里。
序列统计量写成收益率行上的公式,一个价格变了会一路流到年化数字;Mica 没有把结果冻结成数值。