
这个工作簿没有做的样本外测试
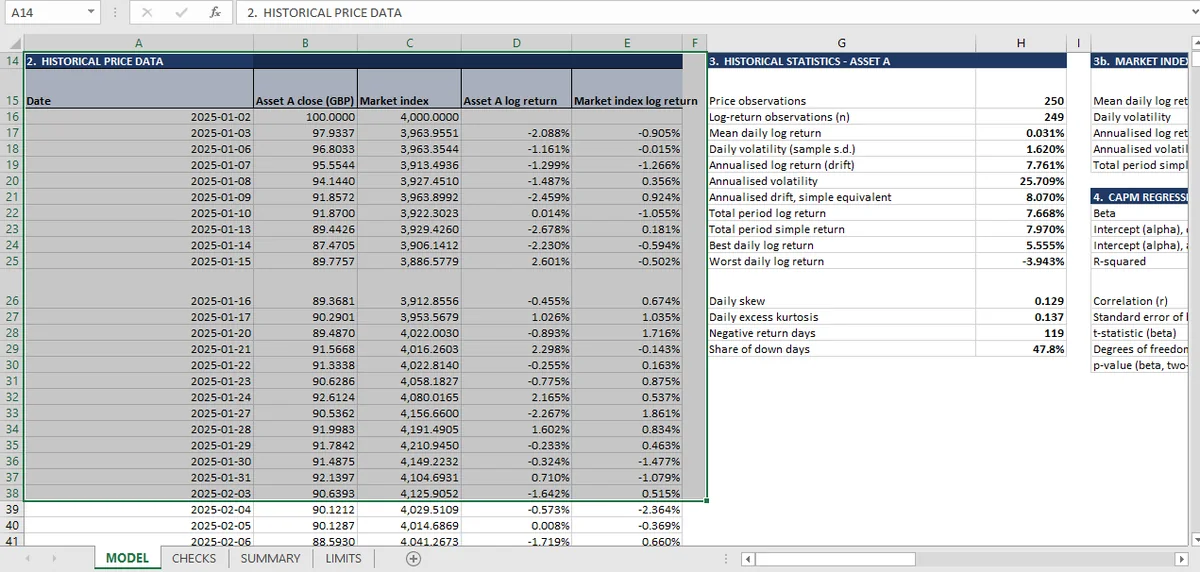
这个工作簿里的每个统计量都算在同样的 249 天上,所以没有一个是样本外的。一次拆分需要比输入包更多的数据;拆分泄漏有三种方式:在全样本上预处理、窗口重叠,以及在看到结果之后才选择拆分。
量化工作簿对一切使用 249 个日收益率:波动率、漂移、回归、模拟。每个统计量都在全样本上计算,没有留出任何数据。
这是一条限制,不是错误。工作簿的任务是检查算术是否正确,而全样本估计是最干净的做法。但把 25.71% 的波动率和 −0.229 的 beta 当成资产描述的读者,跳过了一步,因为两个数字描述的都是它们所拟合的那 249 天。
样本外是什么意思
把序列拆成两半。在前一半估计,在后一半评估。评估是样本外的,因为后一半在拟合中没有扮演任何角色。
结果通常比样本内拟合差,而恶化的幅度就是信息。一个在样本内拟合 20% 方差、样本外只拟合 2% 的模型,是在拟合噪声。一个样本内拟合 15%、样本外 12% 的模型,说明它找到了真东西。
对一项只有一年数据的资产,拆分会在两边都留下太少,什么都说明不了。这就是工作簿不做的原因,也是正确做它需要比输入包更多数据的原因。
拆分泄漏的三种方式
在全样本上预处理。 如果收益率用整条序列做标准化、缩尾处理(winsorized)或去均值,然后再拆分,测试集就影响了模型。均值和标准差必须只来自训练窗口。
窗口重叠。 一个在第 1–150 天训练、在第 100–249 天测试的模型,在 100–150 天重叠,这些天两边都有。重叠不是小泄漏;它是模型在被它见过的数据上测试。
在看到结果之后选择拆分。 试五个拆分、报告最好的那个,是披着样本外标签的样本内选择。拆分必须在拟合模型之前固定。
这些都不稀奇。三者在最终的统计表里都看不见,这就是检查必须是结构性的原因:产生测试统计量的代码,必须看不到测试行。
检查表能断言什么
四项检查,全是机械性的。
- 训练窗口在测试窗口开始之前结束。
- 用来拟合模型的每个统计量都只在训练窗口上计算。
- 测试集在评估步骤之前不被触碰。
- 样本内和样本外结果相邻报告。
最后一条是重要的一条,也是最常被跳过的一条。只显示样本外数字的表隐藏了放弃了多少;同时显示两者的表,让读者看到恶化并判断它。
量化工作簿不带这些检查,限制表也没有提到它们。这就是诚实的缺口:模型检查它算了什么,却对样本是否长到、或代表性足到能支持预测只字不提。
为什么这对其他主题要紧
本系列的每个模型都使用固定样本:四年账目、一条价格序列、一张条款表。每种情况下检查确立内部一致性,而每种情况下都留下了一个问题:换一组数据还成立吗?
这种分工对演示来说是合理的,而当模型被用来预测时就不再合理,两者之间的差别正是这里描述的拆分。
蒙特卡洛一文 是唯一拿模型与自身之外的东西(解析分布)比较的一篇。那个比较之所以可用,只是因为分布是假设的。回归一文 在 p 值里展示了同样的张力,31 项检查的完整表格在量化页面 上。拆分要划分的统计量在收益与时间价值 里,代替外部测试的解析比较在蒙特卡洛里。
拆分首先要改变的东西,是估计窗口;Mica 把估计窗口保留为写明的区间,这一点在表里看得见。