
这个工作簿到底是什么
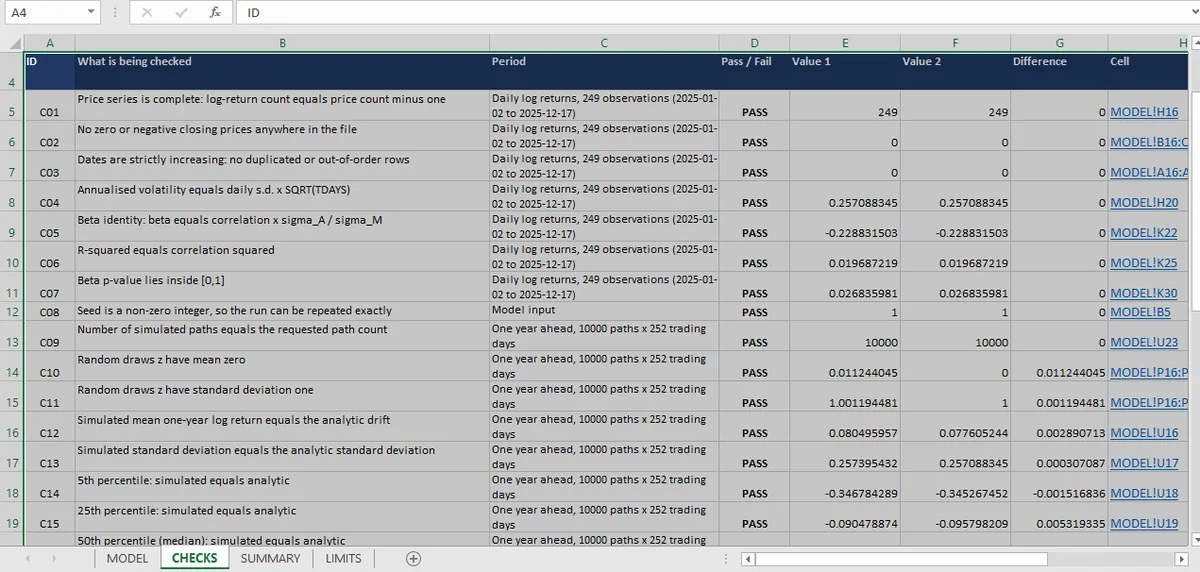
对一条价格序列的 31 项检查:三项数据完整性、四个恒等式、七项模拟、四个分布阶梯、五项树,其余是回归输出。每组回答下一个组依赖的问题。
一条价格序列,四个问题,31 项检查。
问题是:数据干净吗、统计量是否按定义计算、模拟是否复现它假设的分布、回归的结果是否和报告一致。
| 组 | 检查数 | 确立了什么 |
|---|---|---|
| 数据完整性 | 3 | 从 250 个价格得到 249 个收益率、没有零收盘、日期有序 |
| 恒等式 | 4 | 波动率、beta、R² 和 p 值遵循各自定义 |
| 模拟 | 7 | 带种子、10,000 条路径、矩匹配、分位数匹配 |
| 分布与阶梯 | 4 | 模拟和解析的排序都成立 |
| 树 | 5 | 概率和计数与观测对账 |
| 回归报告 | 2 | beta 恒等式与相关系数平方 |
| 分位数与矩比较 | 6 | 模拟对照解析、简单对照对数正态 |
让这个主题不同的模式
在三表模型里,一项检查把工作簿里的一个数字与另一个数字比较。这里,六项检查把模拟与工作簿也会计算的一个公式比较,而那个公式就是模型自己的假设。
这听起来既更弱也更强。更弱,因为建立在「收益率为对数正态」这一假设上、又对照对数正态分位数检查的模拟,检测不出错误假设。更强,因为这是本系列唯一一处数值方法对照闭式答案的测试,而这正是蒙特卡洛需要的测试:没有解析基准,模拟就是一个带种子的数字生成器。
读者该带走的三个数字
25.71% 的波动率,按日标准差乘以交易年度的平方根计算,并对照该恒等式检查。
−0.229 的 beta,配 0.0197 的 R²。 在 5% 水平显著,解释 2%。工作簿两者都报告,而这一对数字,是里面最有用的信息。
0.0053 的最大分位数差距。 这是 10,000 条路径在对数收益率口径下的抽样误差,它给分布的已知精度一个数字。
这些都没有覆盖什么
四件事,都是结构性的,不是遗漏。
一项资产,一年。 没有组合、没有协方差、没有第二种状态。每个统计量描述 249 天。
分布是假设的。 没有正态性检验、没有自相关检验、没有波动率聚集。检查确认模拟匹配假设,不是假设正确。
没有样本外拆分。 每个数字都是样本内的,限制表也没有声称相反。
没有有效前沿。 工作簿的定位,就是一个收益与风险模拟器;带约束的优化器放在组合主题 里。
怎么读这张表
从数据检查开始,因为其余一切继承自它们。然后是恒等式,这是发现错误公式成本最低的方式。然后是模拟比较,这是数值方法唯一遇到闭式解的地方。然后是回归报告,这是模型把判断交给读者的地方。
这个顺序与工作簿检查表使用的顺序相同,也是 31 项就够的原因:每组回答下一个组依赖的问题。
收益一文 从数据开始,蒙特卡洛一篇 是闭式比较,beta 一文 是判断,检查表的完整版本在量化页面 里。表里最小的对象是概率树,这个工作簿省略的那一层是有效前沿。
模拟、回归和检查都读同一条收益率序列,因为 Mica 在工作簿内部搭出这个模型。