
教科书上的规则,以及它在哪里失效
一组变化两次符号的现金流可以有两个正的内部收益率。这个工作簿里就有一组:6.10% 和 163.9%,两者都让 NPV 为零,而 Excel 返回初值碰巧找到的那个。
内部收益率是让 NPV 为零的折现率。取一组常规现金流:先一笔流出,然后流入。恰好有一个正根,而 IRR() 找到它。
符号变化两次,这个保证就没有了。一组有两次符号变化的现金流可以有两个正根,两者都让 NPV 为零,而 Excel 会返回它迭代碰到的那个。
两种情况都出现在这个工作簿的基金模型里。
基金现金流:三次符号变化,一个根
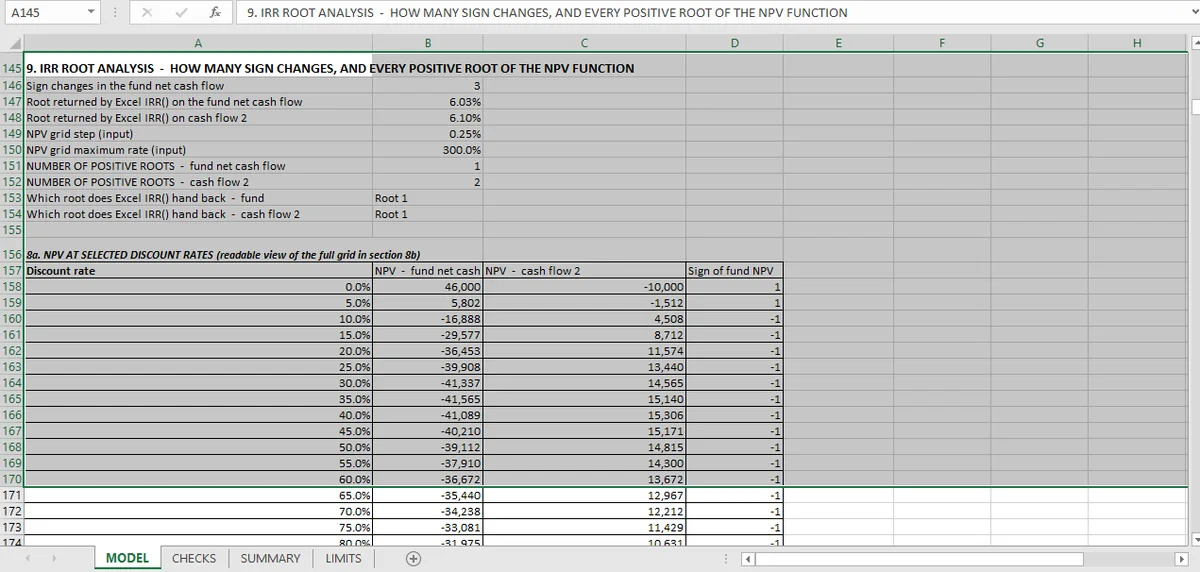
报告的基金流变化三次符号:出资、分配,然后一笔晚期催缴。它恰好有一个正 IRR,6.03%。
三项独立检查确认它:
- 定位到一个根:0.0603197,该点 NPV 为 5 × 10⁻⁵,在容差之内。
- NPV 网格中的零交叉数等于找到的根数:一。
- Excel 的
IRR()落在同一个根上,精确到 10⁻¹¹。
基金现金流是从两页摘要读出来的,有些行需要不止一遍 OCR。瀑布分配和倍数恒等式从同一组现金流计算;漏掉一笔分配改变的是输入,不是算术。
笛卡尔上界也被检查:正根数不能超过符号变化次数。一个根对三次符号变化是一致的。这也是一只真实基金的常见形态:几次符号变化,一个经济上有意义的答案。
第二组现金流:两次符号变化,两个根
工作簿带第二组序列,构造为有两次符号变化。它有两个正根:
| 根 | IRR |
|---|---|
| 1 | 6.10% |
| 2 | 163.9% |
两者都被检查:每个定位根处的 NPV 在容差内为零,NPV 网格中的零交叉数与找到的根数相符,并且显示 IRR() 落在其中一个上,也就是第一个,没有任何迹象表明另一个存在。
这就是失效模式。一个报告「IRR 是 6.10%」的模型,对这个根没有错;它错在认为只有一个根。163.9% 的根同样真实,也同样没有意义。
第二个根为什么没有意义
一组变化两次符号的现金流给出 164% 的 IRR,是再投资假设造成的。IRR 公式假设每笔期间现金流都按 IRR 本身再投资,对第二个根来说,这意味着假设十年里按 164% 的再投资率。同样的假设在项目层面的版本,在NPV 与 IRR 对比 里说明,那里展示两个指标在哪里分叉。
第二个根不是经济情景;它只是符号变化让 NPV 曲线第二次与零相交的结果。
第一个根 6.10% 才是有经济解释的那个。它也是 Excel 恰好返回的那个。返回那个根靠的是初值的运气,而不是方法本身的性质。
让这件事可见的检查
四项,而它们值得照搬。
独立数符号变化。 两次,用两种不同的遍历方式。计数必须一致。
用笛卡尔法则给根定上界。 正根 ≤ 符号变化。这是一个弱上界,能抓住严重错误。
在 NPV 网格上定位根。 逐步移动折现率,找零交叉,再细化每一个。交叉数就是根数。
确认每个定位根处 NPV 为零。 不能把 NPV 归零的根,是求解器产物。
这四项把「IRR」从一次函数调用,变成对根数量的判断。这是知道这个数字是否唯一的唯一办法。
MIRR 如何处理多根问题
MIRR 不说根有几个,它通过明说再投资率把多根问题绕开。对结果没有直接影响。MIRR 通过明说一个利率移除了再投资假设,所以第二个根的荒谬消失了。这组序列的 MIRR 是介于 IRR 与再投资率之间的单一数字。
但 MIRR 不会告诉你 IRR 曾经有歧义。它把一个数字换成另一个;根数问题仍然存在,想要的读者得跑上面四项检查。
实用规则
对任何有不止一次符号变化的现金流,把符号变化次数报在 IRR 旁边。如果次数超过一,就跑一个 NPV 网格并数交叉。
对一只带出资、分配和晚期资本催缴的基金,这几乎总是成立,而答案几乎总是一个经济上有意义的根。检查正是把「几乎总是」与「在这个案例里」区分开的东西。
MIRR 与倍数一文 讲完全不依赖根的回报指标,另类投资页面 收了全部 48 项检查。产生这些现金流的持股关系在股权结构表 里,同样算术的退出价值版本在房地产 DCF 里。
根数就在报告的 IRR 旁边可见,因为 Mica 在表里独立定位每个根。这种可见性是让歧义 IRR 难以漏掉的单元格级审计布局。