
七个组,一组现金流
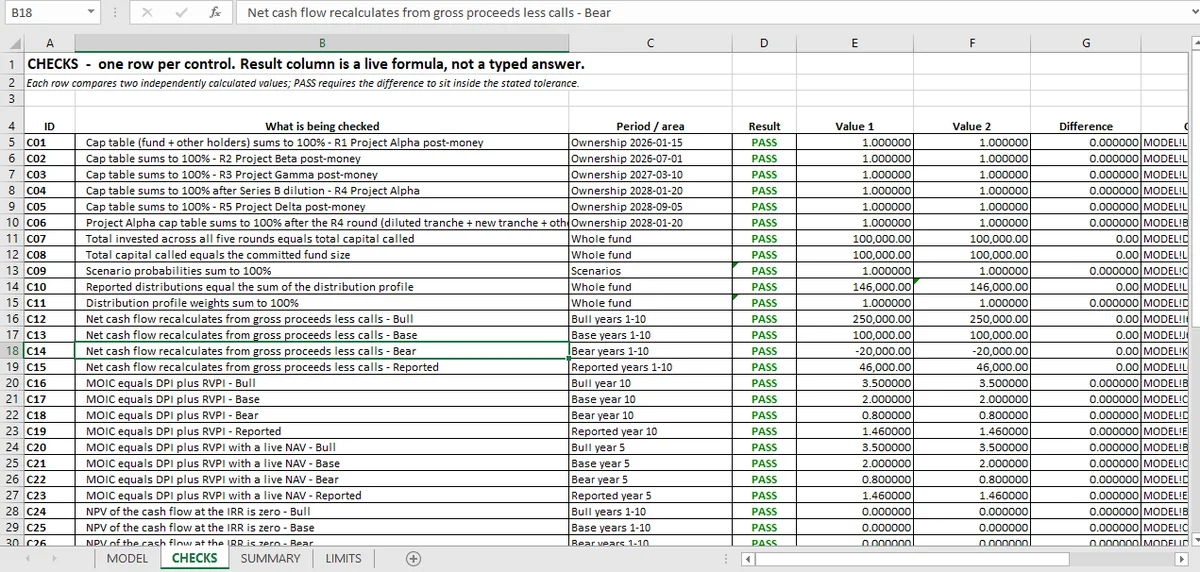
48 项检查沿着现金流一路走:股权结构表、基金流、四个回报指标、IRR 根、MIRR、瀑布分配,以及一个汇总残差。每一层为下一层提供输入,而检查放在接缝处。
基金工作簿用七个层次,搭出十年期私募股权基金的回报,每一层有自己的检查。
| 层 | 检查数 | 确立了什么 |
|---|---|---|
| 股权结构表 | 6 | 每一轮基金与共同投资者之和为 100% |
| 基金现金流 | 9 | 催缴、分配和净流重建 |
| 回报倍数 | 12 | 四个情景、两种方式下 MOIC = DPI + RVPI |
| IRR 根 | 10 | 符号变化、笛卡尔上界、每个根处 NPV 为零 |
| MIRR | 4 | 位于 IRR 与再投资率之间 |
| 瀑布分配 | 6 | 各层加总为可分配金额;carry 是门槛之上的剩余 |
| 汇总 | 1 | 倍数恒等式贯穿一切 |
有意思的结构特点是:各层沿着一个方向逐层传递:持股关系产生收益,收益产生现金流,现金流产生回报,回报驱动瀑布分配。检查放在每个接缝处,而不是只在最后。这条单向链在公司金融里有对应物,即资本预算整合,那里假设为现金流提供输入,现金流再为指标提供输入。
三个值得盯住的接缝
持股关系进入收益。 一张加总到 100% 的股权结构表,如果基金份额取自错误的轮次,仍然可能产生错误的收益。对被稀释那一轮的检查,就是把两者绑在一起的检查。
收益进入现金流。 净现金流必须由分配减去催缴重建,在每个情景里都是。三项检查,每个情景一项,加上报告案例。一个导入净数字并从中报告回报的模型,没有现金流。
回报进入瀑布。 各层必须加总为可分配金额,而 carry 必须是 carry 率乘门槛之上的剩余。六项检查,最后一项抓住按整个分配计算 carry 的错误。
最有用的单项检查
最有用的单项检查,是 IRR 的根数。
一组有三次符号变化和一个正根的基金现金流没问题。一组有两次符号变化和两个正根的现金流,是一个等着出错的报告 IRR。Excel 的 IRR() 不会说它处于哪种情况。
工作簿独立计算根,检查每个根处 NPV 为零,再比较 IRR() 返回什么。这是 48 项检查里的 10 项,也是本系列唯一一处把函数返回值当作对函数本身的判断、而不是当作结果的地方。
48 项没有确立什么
基金是否真实。 每个输入都是构造的:五个轮次、一个分配曲线、情景权重。没有任何东西被校准到真实基金。
回报是否好。 1.46× 倍数上的 6.03% IRR 是报告出来的;它是否补偿了十年流动性不足,是工作簿不做的判断。
瀑布分配是否符合 LPA。 各层以简化形式建模。真实的合伙协议有追赶条款、费用抵扣和回拨条款,会改变 GP 的份额。
房地产是否被覆盖。 本主题有两篇文章,房地产 DCF 和资本化率一篇,描述的是工作簿不包含的方法。把它们放进来,是因为一个私募市场模型少了这两块就不完整;文章里也写明了这一点。
怎么读它
从股权结构表开始。如果持股错了,下游每个回报都错,而检查仍然会通过,因为它们测试的是随后的算术。
然后现金流重建,然后倍数恒等式,然后根数,然后瀑布分配。这与各层搭建的顺序相同,也是 48 项检查够用、不多余的原因:每组测试一个接缝,而有七个接缝。
IRR 一文 是根数案例,倍数一文 是恒等式,稀释一篇 是持股关系的来源,检查表全貌在另类投资页面 上。基金不建模的房地产一侧,在房地产 DCF 和资本化率与杠杆 里。
持股、现金流和 carry 在同一个工作簿里联动,而不是敲进去的;Mica 从端到端搭出这个基金模型。端到端工作簿正是报告自动化 保持各层同步所需要的东西。