
AI 财务建模排名测的是什么
公开排名的评分项是速度、格式和数据准确性。受测工具里没有一款按计息余额来预测利息;少了这一环,就谈不上真正的三表模型。缺掉的那个维度是可验证性:完成后的文件里,有没有审阅者可以重跑的检查。
最有名的 AI 财务建模工具测试来自 Wall Street Prep。它要求每款工具为苹果公司搭一个完整联动的三表模型:三年历史数据取自 10-K 年报和第四季度财报,四年预测取自市场一致预期,格式按投行惯例。然后按给受训分析师打分的标准,给这些工具打分。
结果见已公布的排名:Shortcut 5.9,Claude 5.5,Copilot 4.4,ChatGPT 2.5。水平最低的一组初级分析师得 6.4 分,中间一组 7.9 分,最高一组 9.4 分。没有一款工具够到人类分析师分数线的下限。
评分项正是那些要把模型交给同事的人关心的:工具多快理解任务、历史数字对不对、格式像不像投行的、数据来源站不站得住、预测结构是否扎实。
这是个好测试,回答了一个真问题:让工具起草的模型,我能留下多少能用的东西。但它没回答一个决定模型能不能用的问题:做完的文件能不能被检查。
排名漏掉了什么:可验证性
那个测试里有两个评分项接近可验证性,但都没有真正触及。数据来源问的是工具是否解释数字从哪来;结构问的是各张报表是否彼此一致。两个都没有回答审阅者真正会问的问题:我能不能重跑一遍并得到同一个答案,能不能找到它开始不成立的地方。
这份基准确实报告了一个结果,足以说明这个缺口的代价。在循环引用一项下,它自己的小标题是全部失败:“没有一款工具根据现金和债务余额预测利息收入与利息支出”,因此「模型里没有建立任何循环引用」。债务一项:「没有一款正确处理债务」,大多数「靠硬塞数字凑平,而不是做真正的表间衔接」。
在三表模型里,这些都不是小疏漏。利息如果不跟着计息余额走,就成了一个常数。靠调整项才配平的资产负债表,每一期恒等式都过,每一期也都是错的。这些工具不是解不出难题,而是绕开了,照样在满分 10 分的评分里拿到 4.4 到 5.9 分。
排名看不到这一点,因为排名只是拿输出去对评分表。可验证性是路径的属性,不是输出的属性。
一个可检查的模型应该按什么打分
换个思路:不是换一张更细的评分表,而是换一个问题,并且把这个问题对着文件问,不是对着工具问:这份完成的工作簿满足多少条必须成立的条件,作者以外的人能不能证明这一点?
六类检查覆盖了这个问题,每一类都给出一个数字,而不是一个印象:
| 检查类型 | 产出什么 | 为什么排名看不到 |
|---|---|---|
| 结构 | 每个会计期间成立的恒等式 | 模型可以只在最后一列平 |
| 一致性 | 各期一致的公式 | 手工补丁看起来也像公式 |
| 约束 | 最优解是否满足约束 | 越界的最优解看起来仍像答案 |
| 收敛 | 两种方法、一个数字、一个差值 | 单一方法无法审计自己 |
| 敏感性 | 响应的方向与合理性 | 平滑地错下去的模型能通过其余所有检查 |
| 已知行为 | 识别方法的已知特性,而不是误判 | 正确的模型可能被判错 |
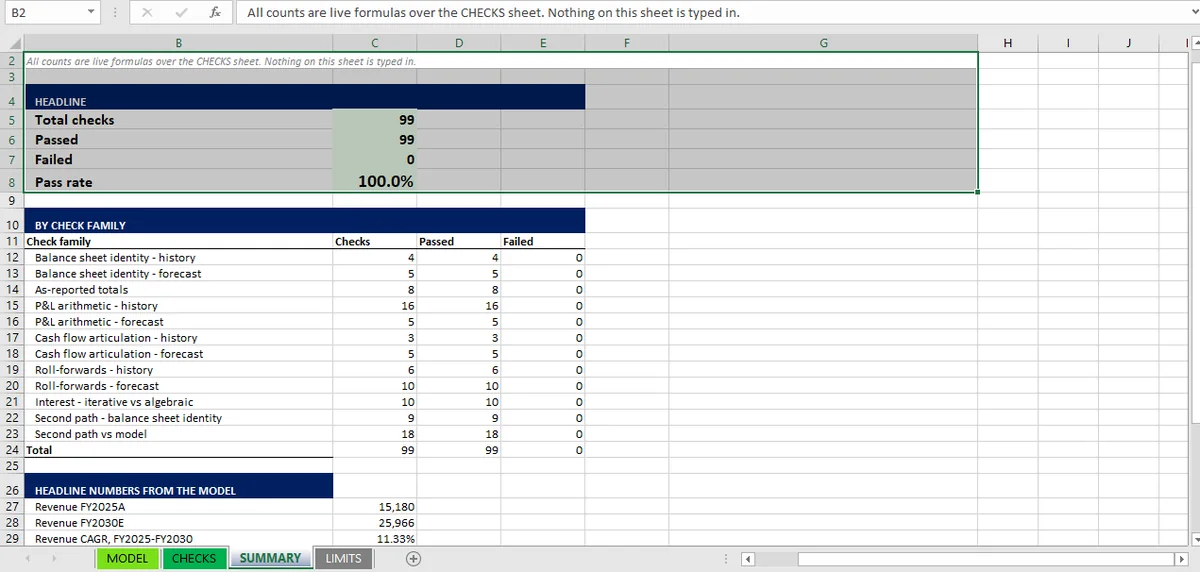
本系列的工作簿就是为产出这些数字搭的,结果并不光鲜:99 项检查全部通过,但期末现金是 −1,113,因为模型里没有安排任何融资。真正要紧的不是 99,而是最后这个数字——满分 10 分的任何分数都不会把它翻出来。
各家工具在检查上的对比
目前还无法比较,与其暗示一个排名,不如把原因说清楚。
要对一款工具跑检查流程,就得给它同一套输入、拿着同一份答案,再用同样这 99 条检查给它返回的工作簿打分。这件事只做过一次,只在一个模型上,只由一个团队完成(就是这一个);这只是一个案例演示,不是全面测评。
能从公开测试里比较的,是各工具在检查通常失败的那些点上的表现:
| 测什么 | Shortcut | Claude in Excel | Copilot | ChatGPT |
|---|---|---|---|---|
| 根据现金和债务余额预测利息 | 否 | 否 | 否 | 否 |
| 正确处理债务明细表 | 否 | 否 | 否 | 否 |
| 公开测试总分 | 5.9 | 5.5 | 4.4 | 2.5 |
四款工具,在决定三表模型算不算模型的这两个点上,答案完全一样。这个发现只针对某一天的一项测试,却是「起草速度和可验证性是两回事」最有力的证据。
这个结果并不证明没有工具能通过检查流程。流程只应用过一次,通过它的是 Mica;不过有一点必须说明:模型和检查是同一个团队做的。这句说明也解释了为什么本系列的每篇文章都区分一个工作簿内部的交叉检查与外部审计,以及为什么数字要完整公布,而不是只给摘要。
该问供应商哪些问题
如果你要选一款工具来做会被他人依赖的工作,排名只是起点,剩下的是下面五个问题。这些问题在演示里就能回答,而且答案可以被证伪。
- 它会在文件里留下一张检查表吗? 不是报告,也不是聊天窗口里的总结,而是工作簿里会随模型变化自动重算的行。
- 它会把任何东西算两遍吗? 利息、收益率、久期、期权价格。如果答案是「否」,就问它到底验证了什么、怎么验证。
- 我能删掉一张明细表,看看哪里会坏吗? 这测的是模型的各个部分是真的联动,还是只是挨在一起。
- 限制表上写了什么? 不产出限制表的工具,等于宣称模型覆盖了一切,而这恰恰是唯一一个必然站不住脚的说法。
- 我明天能在同一个文件上重跑同一个提示词吗? 这里的关键是文件留在本机:如果工作簿在两次运行之间离开过这台机器,证据链就有缺口。
Mica 把假设输入和计算单元格分开,所以一次情景改动可以追溯到它影响到的输出。这同时回答了第一个和第五个问题,而且能在工作簿里验证,不是在营销页上。
这些问题背后的工具格局,在免费 Excel AI 工具指南 和 ChatGPT/Claude/Copilot 对比 里有比较;动作机器人趋势文章 则是品类层面的视角。
谁该看这份排名,谁不该看
公开分数对一类买家回答的是真问题,对另一类买家回答的却是一个误导性的问题。
如果你起草是为了理清思路,这份排名几乎正好是你要的。一款得 5.9、十五分钟就能完成的工具,确实改变了你产出初稿的速度;而那些让它够不到人类分析师分数线的错误,本来也是你在初稿阶段会犯的。用它,然后把重要的部分重搭一遍。
如果你起草是为了交出去,这份排名就不是该用的工具。分数描述的,是一份还得由称职分析师补完的草稿;它对完成后的文件能否被一个当时不在场的人审阅,只字不提。那正是检查表要回答的问题,而目前四款工具没有一款答得上来。
如果你是在为团队采购软件,两样都要。分数告诉你工具会不会被用起来;检查表告诉你产出能不能站得住。一款得分高却不留证据的工具,等于把复核成本从分析师转嫁给最后签字的人,这是实打实的风险转移,不是省钱。
如何自己跑一套检查流程
这一切都不需要供应商配合。流程可以在任何工作簿上跑,一个下午就够,文件甚至不用关。
选五条检查条件,不要九十九条。 每个会计期间一条资产负债表恒等式,一张滚动表,一条报表衔接测试,一条双方法比较,一个敏感性方向。五条就够区分模型和草稿,而且少到一个下午做得完。
把它们写成公式,放在一张空表里。 每一行都该有两个数值、差值和通过标记。用文字描述的检查是愿望;写进单元格的检查才是证据。
标出每项检查读取的单元格。 这一步常被跳过,但正是它把一个危险信号变成具体位置。少了它,失败的检查只告诉你模型错了,却不告诉你错在哪。
故意把模型弄坏。 改一个驱动项,确认检查仍然通过,再改回来。如果模型没动,检查结果却变了,那要么检查错了,要么联动错了。无论哪种,你都知道了静态文件不会告诉你的事。
把检查表留在你发出去的文件里。 检查表只留在自己的工作副本里,文件一发给别人,这套检查就没了。跟着文件走的检查表,才能让任何收到文件的人审计这个模型。
上面这套流程就是六类检查 里描述的那一套,只是应用到了任何一个产出该文件的工具上。这套流程刻意做得平平无奇,价值恰恰在于它不依赖对执行者的信任。
这个排名对选择工具意味着什么
这份排名能告诉你工具起草得快不快,但不能告诉你产出能不能被验证。三条结论,按确信程度排列。
起草速度已经解决,不再有区分度。 公开测试里的每款工具都在大约一小时内产出了三表模型,两款领先的只用了约十五分钟。按速度选型,等于挑了一个各家差距最小的指标。
可验证性尚未解决,而且在排名里根本看不见。 公开测试中没有一款工具根据产生利息的余额来预测利息。仅这一处遗漏,就足以让一个三表模型不配叫三表模型;可它并没有妨碍四款工具中的任何一款拿到中游分数。
检查这件事,买家自己也能要求,不只在供应商手里。 向对方要检查表。如果工具拿不出来,这个模型无论看起来多好都是草稿;而十二项勾稽 手工跑一下午就能完成。这就是把模型留在 Excel 里、而不是关进黑箱的全部理由:证据跟着文件走。
想了解这些数字背后的方法,从六类检查 开始;想看唯一一个从头跑到尾的模型,去看三表工作簿;想看目前每款公开工具都通不过的检查,去看利息循环引用。
*本文比较的是公开测试结果与一套方法论,不构成投资建议。没有供应商为排名付费,上文报告的结果均来自文中注明的来源。*
输入与计算分开存放,买家才能拿同一份检查表自己重跑;这是 Mica 在文件里保持的基本结构。