
Black-Litterman 解决的问题
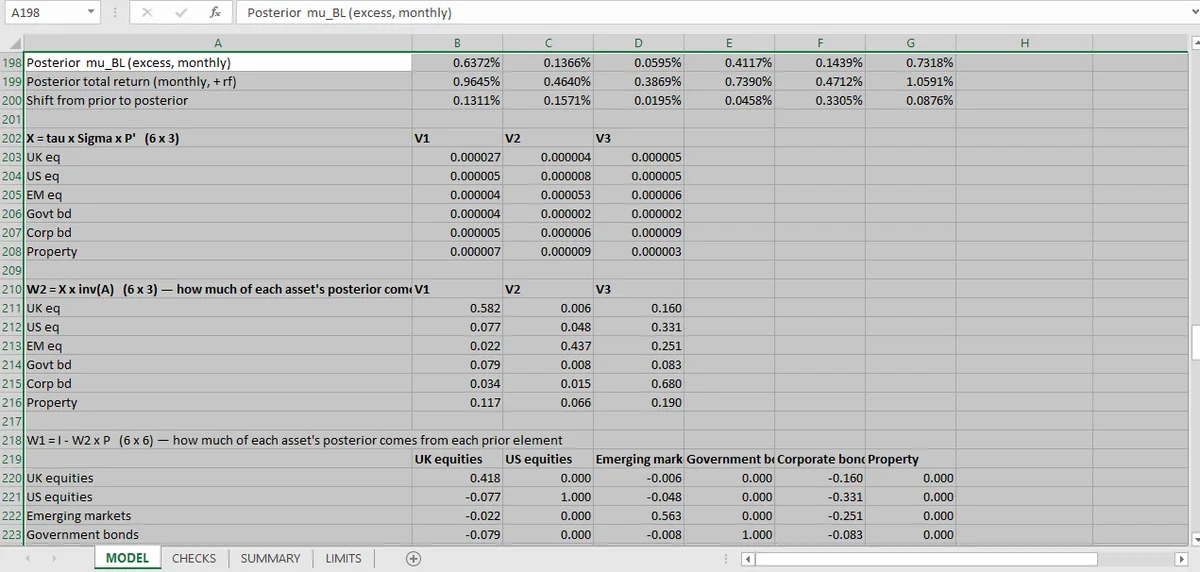
Black-Litterman 用一个后验替代原始收益估计:一个市场隐含的先验,由明确观点更新。工作簿从组成部分重建后验,并检查这个混合表现得像加权平均,观点权重在 0.17 到 0.75 之间。
均值-方差优化需要预期收益。这些收益是整个模型里最不可靠的输入,而优化器把它们的误差放大成极端权重。
Black-Litterman 用一个后验替代原始估计:一个由市场权重隐含的先验,由明确观点更新。输出是一个收益率向量,它从市场相信的东西出发,只在观点能证明的范围内移动。
那是一个建模选择,而工作簿里的检查测试混合的算术是否正确。
三个输入
先验由协方差矩阵和市值权重推导,再按风险厌恶参数缩放。它是让市场组合成为最优的那个收益率向量。这个反向优化是有效前沿 的镜像,后者把收益当作给定并求解权重。
观点是带不确定性的陈述:一项资产将比另一项多赚某个幅度,并带有明说的信心水平。
混合是一个矩阵运算,按先验和观点的相对不确定性给它们加权。工作簿计算它并报告后验。
四项检查
| 检查 | 确立了什么 |
|---|---|
| 后验从先验和观点重建 | 矩阵运算按设定实现 |
| 先验与观点权重之和为 1 | 混合是加权平均,不是重新缩放 |
| 最小观点权重 ≥ 0 | 没有哪个资产的后验权重来自负贡献的外推 |
| 最大观点权重 ≤ 1 | 没有资产完全由观点驱动、绕过先验 |
最强的是重建检查:从组成部分重算后验,再与报告的向量比较。在工作簿的容差下,最大残差为零。
权重检查是结构性的。它们断言混合表现得像加权平均,这正是 Black-Litterman 的本质,而不是一个碰巧产生合理数字的任意变换。
后验长什么样
对英国股票,后验月超额收益是 0.637%。观点权重从 0.170 到 0.748,意味着没有资产的后验超过四分之三由观点驱动,也没有资产低于六分之一。
这个范围是本节信息量最大的输出。一个 95% 由观点构成的后验,是一个披着先验外衣的观点向量;一个 5% 由观点构成的后验,完全忽略了分析师。工作簿报告范围而不是点估计,让读者看到答案里有多少是判断。
检查不能告诉你什么
先验是否正确。它由市场权重和协方差矩阵隐含。如果市场组合不是最优的——现实中它并不是——先验就只是一种惯例。
观点是否正确。它们是带信心水平的输入。一个自信的错误观点,会把后验推得比一个不确定的正确观点更远。
后验是否改善组合。工作簿停在收益率向量。它没有用它重新优化,所以没有衡量得到的权重是否优于原始估计的权重。
最后一个缺口值得补上。Black-Litterman 的卖点是它的权重比原始均值-方差更稳定、更能分散;工作簿的 24 项检查确立混合的算术,把表现问题原样留着。
后验只有在优化器能对它采取行动时才有用:KKT 一文 是会在重新优化后的权重上跑的东西,约束扫描 是可行性一侧。等风险的替代方案是风险平价,想逐项复跑这 24 项检查,可以从组合页面 开始。
先验、观点和混合权重各占一个独立区块,后验因此可以逐格重建;Mica 搭表时没有把它们揉在一起。分成独立区块,重建检查才做得到;这是工作簿布局。