
最初の3つのチェックはファイルについて
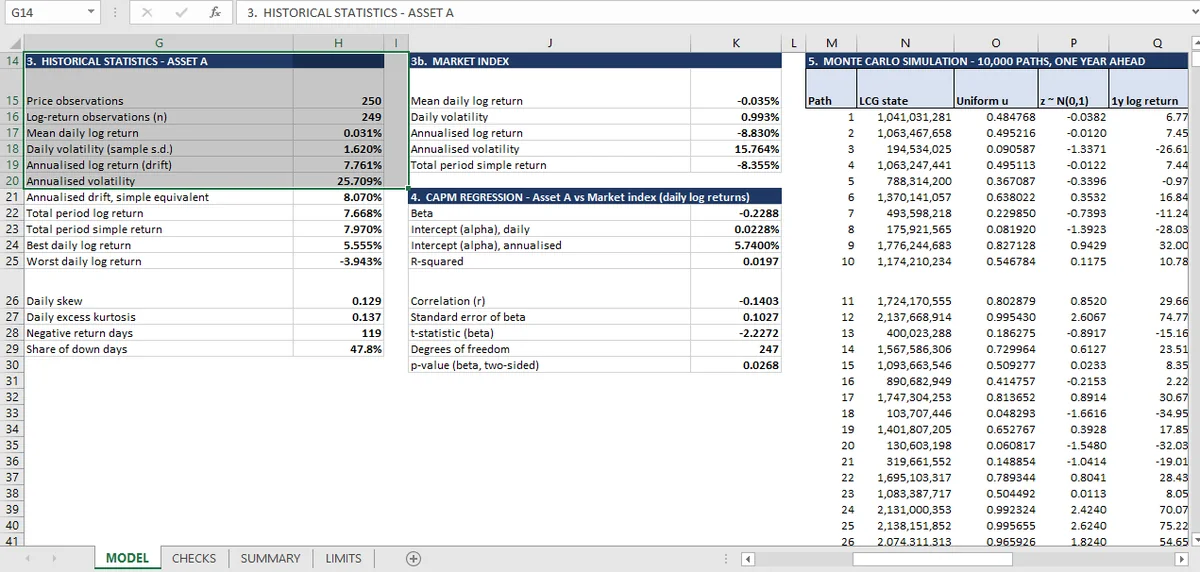
年率ボラティリティは日次標準偏差×取引年の平方根で、249リターンで25.71%です。対数ドリフトは7.76%。解析的な対数正規平均は11.70%、単純リターンの平均は12.03%と高くなります。対数正規の平均は対数平均より上にあるからです。
統計を計算する前に、価格系列について3つが真でなければなりません。リターン数が価格数より1つ少ない、終値がゼロまたは負でない、日付が厳密に増加している。
3つのチェックは些細に見えます。エラーを出さずに下流のすべてを壊す失敗で、リターン系列のクリーニングの最初の一歩です。
行が欠ける とリターン数が変わり、数に基づくすべての統計が変わります。250あるべき価格が249の系列は248リターンを生み、そこから計算した年率ボラティリティは問題なく見える数字です。
価格がゼロ だと対数リターンが無限になります。Excelはそのセルに #NUM! を出しますが、そのリターンをエラーを無視する AGGREGATE で平均すると、系列の残りで気づかれないまま平均されます。価格がゼロでも負でもないというチェックは、見えない破損のクラス全体への最も安い防御です。
日付が順不同 だと、誤った間隔のリターンが生まれます。金曜から水曜、次に火曜から木曜というように。何もエラーになりません。並べ替えた行で計算した対数リターンも合計は同じになるので、誤りが見えにくいのです。
ここでは3つすべて合格です。250価格から249リターン、非正の終値ゼロ、順序違反ゼロ。
250の終値はPDFの価格ファイルから読み取り、いくつかの印字は複数回のOCRパスを要しました。データチェックは欠けた行、ゼロ価格、順不同の日付を捕まえますが、6を8と読んだ数字は捕まえません。その誤りは下流のすべての統計を変えます。データチェックは構造的で、転記はその範囲外です。
ボラティリティの恒等式
最初の本物の統計は年率ボラティリティ、25.71%です。
チェックは外部の数字との比較ではなく恒等式です。年率ボラティリティは日次標準偏差×取引日の平方根に等しくなければなりません。モデルが数字をハードコードしたり、取引カレンダーの代わりに365を使ったり、対数リターンではなく単純リターンで標準偏差を計算したりすれば、恒等式は失敗します。
それが単一の系列で恒等式チェックを有用にする理由です。25.71%と比べる外部ソースはありませんが、定義があり、モデルはそれを満たさなければなりません。
ドリフトと、2つの平均の違い
年率対数ドリフトは7.76%です。ワークブックには2つの平均が現れ、同じ数字ではありません。
対数リターンの算術平均 はシミュレーションに入るドリフト・パラメータです。0.0776です。
単純リターンの平均 はより高く、シミュレーションで0.1203、解析的な対数正規平均は0.1170です。対数正規の平均は、その対数平均の指数を分散の半分だけ上回ります。その関係自体がチェックです。
どちらの平均かを言わずに「平均リターン」を引用するのは、定量ライティングで最もよくある誤りの1つで、ここでの差は、リターン8%の資産では年4パーセントポイントになります。
これらのリターンと時間価値のチェックが短い理由
チェックが短いからです。3つのファイル整合性テストと4つの恒等式は長い弁明を必要とせず、実行される必要があります。
それらが確立するのは、他のすべてへの入力がきれいな系列で、3つの基本統計が定義から計算されていることです。確立しないのは、系列がよいサンプルであることです。249日は1年、1レジーム、1資産です。
この数字を消費するシミュレーションはモンテカルロの記事、同じ系列を使う回帰はベータの記事、31件のチェックシートは定量手法のページにまとまっています。同じ系列の2分岐版は確率ツリーに、その上のポートフォリオ層は効率的フロンティアにあります。
系列の統計は、Micaがリターン行に対する数式として計算します。価格が変われば、年率の数字まで流れます。