
観測リターン上の二項ツリー
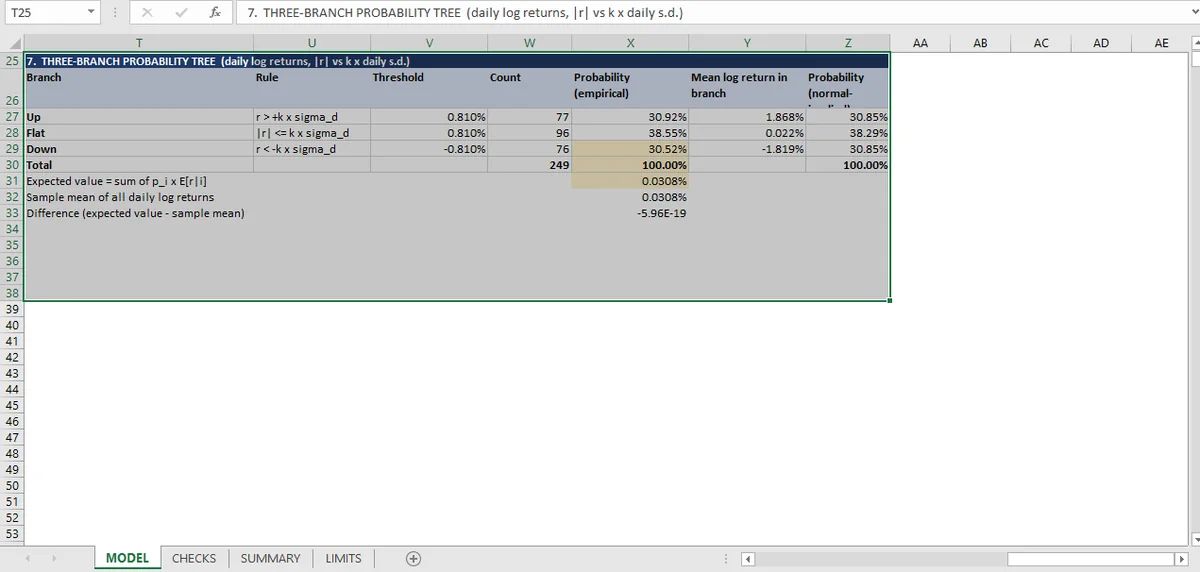
249日次リターンにわたる2分岐ツリーは3つを満たさなければなりません。確率の合計が1、分岐数の合計がサンプル、期待値が両方から再構築されることです。実証の上昇分岐確率は0.3092で、正規分布が含意する0.3085に対してです。
ワークブックは価格系列から最も単純な確率ツリーを作ります。249の日次対数リターンそれぞれを上昇日か下落日に分類し、それぞれの実証確率をカウントから計算します。
次に2つを確認し、3つ目がそこから続きます。
確率の合計が1。 上昇+下落が正確に1で、近似ではありません。些細な算術であり、穴のある分類ルールを捕まえるチェックでもあります。たとえばゼロリターンを除外するしきい値は、いくつかの日をどちらの分岐にも入れません。
分岐数の合計が観測数。 上昇分岐数+下落分岐数が249に等しい。確率ではごまかせないチェックです。2つのパーセンテージが1に合計してもカウントがサンプルに合計しないなら、どちらかの分岐が異なる行範囲で計算されています。
期待値が両方から再構築される。 分岐値の確率加重合計が、独立に計算した期待値に等しくなければなりません。ここでの差は 6 × 10⁻¹⁶ です。
正規分布が含意する確率
興味深いチェックは4つ目です。ツリーの上昇分岐確率は、同じリターンに当てはめた正規分布からも導け、2つは近いはずです。
| 出どころ | 上昇分岐確率 |
|---|---|
| 実証カウント | 0.3092 |
| 正規分布の含意 | 0.3085 |
差は0.0007、確率の7ベーシスポイントです。249観測への正規の当てはめが生むべきもので、同時に2つの証拠です。分類が正しく数えていること、そしてこのサンプルサイズでリターンが極端に非正規ではないこと。
リターンが正規であることの証明でもありません。上昇分岐確率の0.07%の差は弱いテストです。上下の分割は分布の最も粗い要約で、ファットテールの系列はそれを正確に満たしながら1%と99%パーセンタイルで失敗し得ます。
ツリーは何のためにあるか
日次データの2分岐ツリーは真剣な不確実性モデルではありません。教育用の構造です。確率、分岐、期待値を持つ最小の対象で、したがって3つの一貫性チェックを走らせられる最小の対象です。
だからチェックシートに入るのです。より大きなモデルはどれも同じ3つの要件を持ちます。決定木、シナリオツリー、格子です。2分岐で失敗するモデルは200分岐でも失敗します。
持ち帰るべきパターンは3つ目のチェックです。確率とカウントはどちらも内部的に一貫させるのは簡単で、両方から期待値を再構築して比べることが、誤った範囲で計算された分岐を捕まえます。
モンテカルロの記事は2つの分岐を10,000経路に置き換え、同じ考えを保ちます。シミュレーションが生んだものと分布が含意するものを比べます。31件のチェック一覧は定量手法のページに置かれています。分岐に入るリターンはリターンと時間価値に、同じ系列で推定したベータは回帰にあります。
カウントと確率を分けて保つMicaのワークブックでは、突合は主張ではなく算術になります。