
ワークブックが行わないアウト・オブ・サンプル・テスト
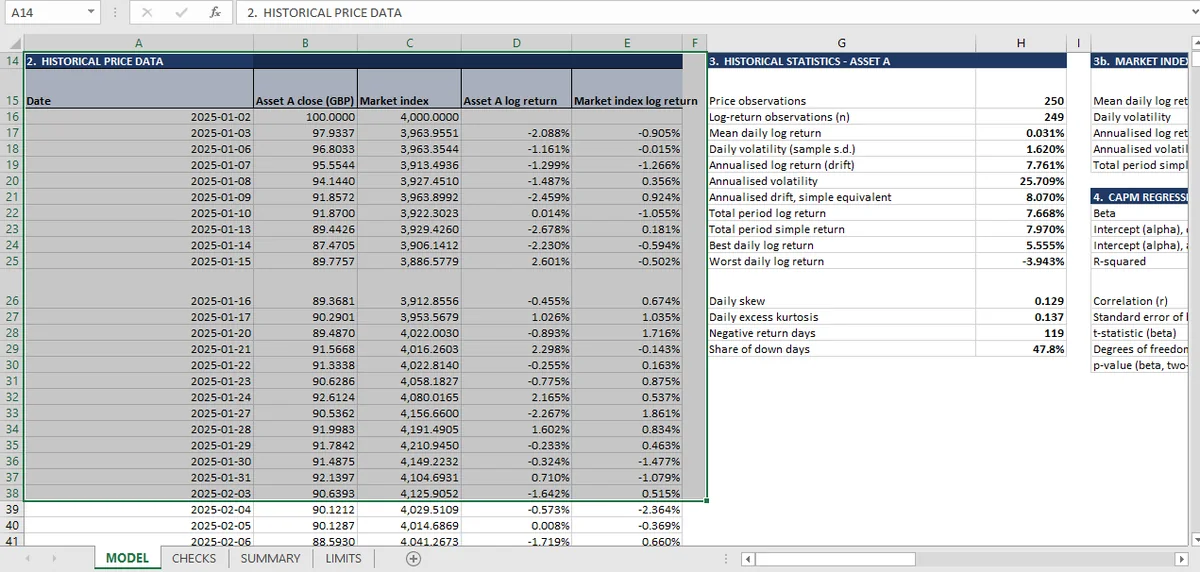
このワークブックのすべての統計は同じ249日で計算されるので、アウト・オブ・サンプルのものはありません。分割には入力パックが持つ以上のデータが必要です。漏れる3つの経路は、全サンプルでの前処理、重複するウィンドウ、結果を見てから分割を選ぶことです。
定量のワークブックは、ボラティリティ、ドリフト、回帰、シミュレーションのすべてに249の日次リターンを使います。すべての統計は全サンプルで計算され、何も取り置かれていません。
それは限界であり、エラーではありません。ワークブックの役目は計算が正しいことを確かめることで、全サンプルでの推定が最もきれいな方法です。ただし25.71%のボラティリティと−0.229のベータを資産の説明として受け取る読者は、1つの手順を飛ばしています。どちらの数字も、当てはめた249日を記述したものだからです。
アウト・オブ・サンプルとは何か
系列を2つに分けます。前半で推定し、後半で評価します。後半は当てはめに関与していないので、この評価はアウト・オブ・サンプルです。
結果は通常、標本内の当てはめより悪くなり、悪化の大きさが情報になります。標本内で分散の20%、アウト・オブ・サンプルで2%を当てはめるモデルは、ノイズに当てはめていたのです。15%と12%なら何かを見つけています。
1年分のデータしかない単一資産では、分割するとどちら側も何かを言うには少なすぎます。ワークブックがそれをしない理由であり、正しく行うには入力パック以上にデータが必要な理由です。
分割が漏れる3つの経路
全サンプルでの前処理。 系列全体を使ってリターンを標準化したり、ウィンザライズ(外れ値を上下限に置き換える処理)したり、平均を引いたりしてから分割すると、テスト集合がモデルに影響しています。平均と標準偏差は訓練ウィンドウだけから取らなければなりません。
重複するウィンドウ。 1〜150日目で訓練し、100〜249日目でテストするモデルは、100〜150日目で重なります。この期間は両方に含まれます。重複は小さな漏れではなく、モデルが見たデータでテストしていることです。
結果を見てから分割を選ぶ。 5通りの分割を試して最良を報告するのは、アウト・オブ・サンプルの看板を付けた標本内の選択です。分割はモデルを当てはめる前に固定しなければなりません。
どれも珍しい話ではありません。3つとも最終的な統計の表には見えません。だからチェックは構造的でなければなりません。テスト統計を生むコードが、テスト行を見られないようにしなければなりません。
チェックシートが検証できること
4つの検証で、どれも機械的です。
- 訓練ウィンドウはテストウィンドウが始まる前に終わる。
- モデルの当てはめに使う統計はすべて訓練ウィンドウだけで計算する。
- テスト集合は評価の段階まで触らない。
- 標本内とアウト・オブ・サンプルの両方の結果を、隣り合わせに報告する。
最後の1つが重要で、最も飛ばされがちです。アウト・オブ・サンプルの数字だけを示す表は、どれだけ諦めたかを隠します。両方を示す表なら、読者は悪化を見て判断できます。
定量のワークブックはこれらのチェックを備えておらず、制約・限界シートにも書かれていません。それが正直な欠落です。モデルは計算したものを検証し、サンプルが予測を支えるのに十分長いか、十分に代表的かについては何も言いません。
これが他のトピックで重要な理由
このシリーズのどのモデルも固定のサンプルを使います。4年分の財務諸表、1本の価格系列、1枚のタームシート。いずれの場合もチェックは内部の一貫性を確立し、いずれの場合も「別のデータでも成り立つか」という問いは開いたままです。
この役割分担はデモとしては妥当ですが、モデルを予測に使うと妥当でなくなります。その2つの違いが、ここで述べた分割そのものです。
モンテカルロの記事は、モデルを自分自身の外にあるもの、つまり解析的な分布と比べる唯一の記事です。その比較が可能なのは、分布を仮定したからにすぎません。回帰の記事は同じ緊張をp値で示し、31件のチェックは定量手法のページに一つずつ並んでいます。分割が分けることになる統計はリターンと時間価値に、外部テストの代わりになる解析的な比較はモンテカルロにあります。
推定窓を明示した範囲としてシートに残すMicaのワークブックでは、分割が最初に変えるべきものになります。