
La única prueba de Monte Carlo que significa algo: la forma cerrada
Diez mil trayectorias con semilla reproducen una distribución lognormal: los percentiles del 5 al 95 coinciden con la forma cerrada dentro de 0,0053, que es error de muestreo y no error de modelo. La semilla hace reproducible la ejecución; la comparación la hace comprobable.
Un Monte Carlo produce una distribución. Solo es útil si esa distribución coincide con la que supone el modelo. La forma de responder a eso es calcular la misma distribución analíticamente y comparar.
Para un activo lognormal, la respuesta es en forma cerrada. Los percentiles 5, 25, 50, 75 y 95 a un año se derivan directamente de la deriva y la volatilidad. La simulación no tiene esa fórmula; tiene 10.000 trayectorias y un recuento.
La ejecución: 10.000 trayectorias con semilla
El libro extrae 10.000 trayectorias del generador con semilla, con la semilla 20250101 guardada en una celda. Tres comprobaciones confirman la propia ejecución:
- La semilla es un entero distinto de cero, así que el resultado es reproducible.
- El número de trayectorias es igual al recuento solicitado.
- Las extracciones aleatorias tienen media cero y desviación típica 1: 0,0112 y 1,0012, que es lo que cabría esperar de 10.000 extracciones normales.
Esa tercera comprobación es la que la gente se salta. Un generador con un sesgo sutil, como una correlación entre extracciones sucesivas o una cola truncada, seguirá produciendo una distribución de aspecto plausible. La única evidencia barata son los dos primeros momentos de las extracciones.
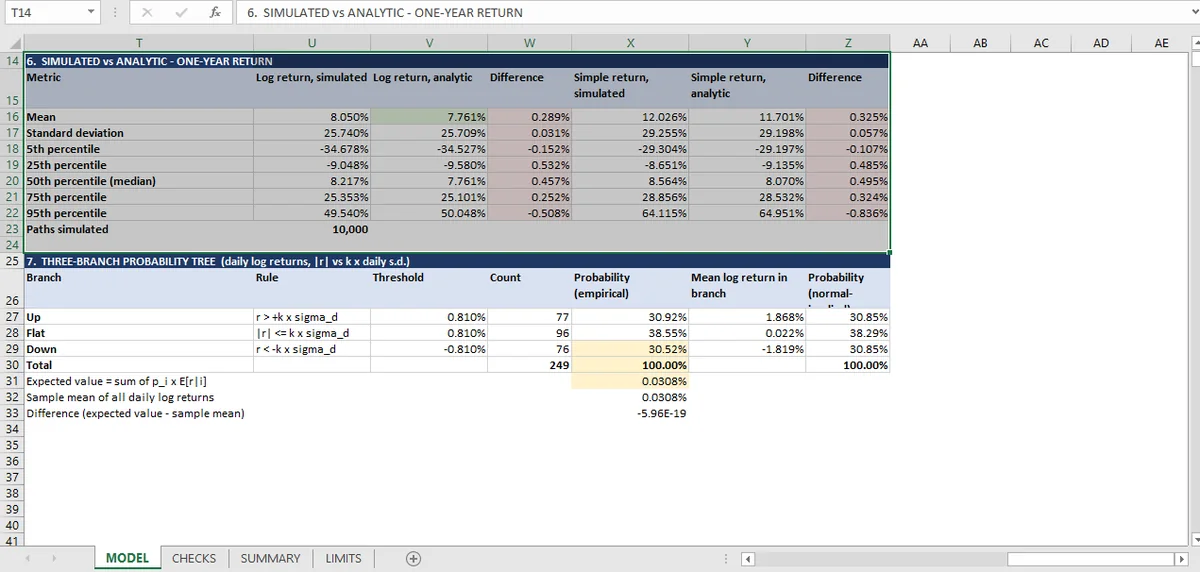
Comparar los percentiles simulados y analíticos
| Percentil | Simulado | Analítico | Brecha |
|---|---|---|---|
| 5 | −0,3468 | −0,3453 | 0,0015 |
| 25 | −0,0905 | −0,0958 | 0,0053 |
| 50 | 0,0822 | 0,0776 | 0,0046 |
| 75 | 0,2535 | 0,2510 | 0,0025 |
| 95 | 0,4954 | 0,5005 | 0,0051 |
La mayor brecha es 0,0053 en términos de rentabilidad logarítmica. Es el error estándar de Monte Carlo con 10.000 trayectorias, no un error de modelización. Un percentil estimado a partir de una muestra finita tiene su propia distribución muestral, y no se reduce a cero.
Otras dos comprobaciones cubren los momentos en lugar de los percentiles: la media y la desviación típica simuladas frente a las analíticas. Media 0,0805 frente a 0,0776, desviación típica 0,2574 frente a 0,2571. De nuevo la brecha es ruido de muestreo, y de nuevo el punto es que el modelo tiene una respuesta independiente con la que comparar.
Qué significa convergencia aquí
La convergencia en un Monte Carlo no es una sola cifra. Es una afirmación sobre el error estándar, que cae como la raíz cuadrada del número de trayectorias: cuadruplicar las trayectorias reduce el error a la mitad.
Diez mil trayectorias dan un error estándar en un percentil de aproximadamente una centésima de la dispersión de la distribución. Por eso las brechas anteriores están en el tercer decimal. Si el modelo necesitara dos decimales, necesitaría aproximadamente cien veces más trayectorias.
El libro no prueba la convergencia ejecutando distintos números de trayectorias. Comprueba contra la respuesta analítica, que es más fuerte: un modelo que coincidiera con 10.000 trayectorias y divergiera con 50.000 fallaría una comparación por número de trayectorias y pasaría la analítica.
La cuestión de la semilla
Una ejecución con semilla es reproducible y no independiente. La misma semilla produce las mismas trayectorias, que es lo que hace reproducible la hoja de comprobaciones. También significa que la simulación es una extracción, no la media de muchas.
El uso honesto es tratar la semilla como parte de las entradas del modelo, igual que la volatilidad: si la cambias, las cifras se mueven en la cuantía mostrada arriba. Una hoja de comprobaciones que se vuelve a ejecutar con dos semillas y compara los percentiles somete a la misma prueba que la comparación analítica, desde la otra dirección.
Qué no demuestra la convergencia de Monte Carlo
Que el activo sea lognormal. La simulación se construye sobre ese supuesto y después se comprueba contra él. La comparación de percentiles depende, por tanto, del supuesto: un activo con colas gruesas simulado como lognormal coincidiría con los percentiles por definición y no diría nada sobre la cola.
La regresión sobre la misma serie, el artículo de beta, es el único lugar donde el libro mira si los datos se comportan como se supone, y encuentra un R cuadrado del 2 %. El artículo del árbol cubre la versión de dos ramas de la misma comparación, y la portada de métodos cuantitativos reúne las 31 comprobaciones completas. La serie que se simula está en rentabilidades y valor temporal, y la pregunta de cartera que la simulación no responde está en la frontera eficiente.
Cambiar la semilla vuelve a ejecutar cada trayectoria y cada percentil a la vez porque Mica recalcula toda la simulación sobre el propio archivo.