
Monte Carlo: una serie de precios, 31 comprobaciones
El caso. Entró una serie de precios: 250 cierres diarios de un archivo de precios en PDF, 249 rentabilidades logarítmicas, para un solo activo, más un índice de mercado para la regresión. Todo lo demás se calcula a partir de ella: la volatilidad anualizada, la deriva logarítmica, la regresión y una distribución a un año simulada con 10.000 trayectorias a partir de la semilla 20250101. La hoja de límites la trata como un solo activo y una sola muestra: sin cartera, sin segunda serie y sin prueba fuera de muestra. Un ejemplo completo de importación de CSV de una serie de rentabilidades está en el recorrido CSV/MA10. Es un caso sintético para demostrar un método, no asesoramiento de inversión, fiscal ni legal.
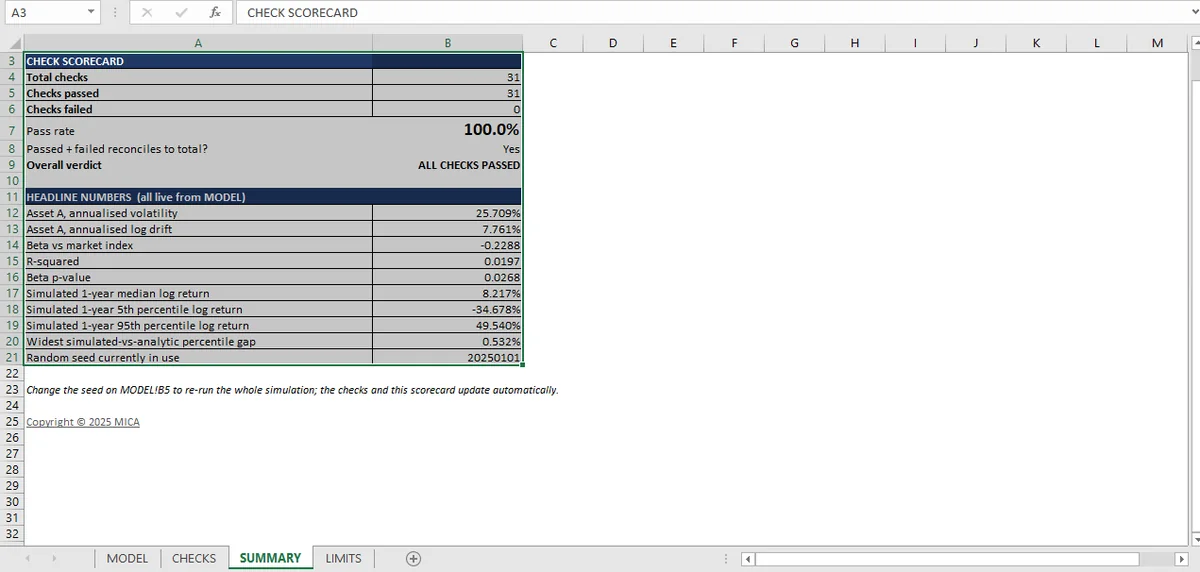
Una serie de precios, 249 rentabilidades, diez mil trayectorias con semilla. La volatilidad es 25,71 %, la beta es −0,229 con un R cuadrado de 0,0197, y cinco percentiles simulados coinciden con la fórmula lognormal dentro de 0,0053.
| Medida | Resultado |
|---|---|
| Observaciones | 250 precios, 249 rentabilidades logarítmicas |
| Volatilidad anualizada | 25,71 % |
| Deriva logarítmica anualizada | 7,76 % |
| Beta frente al índice de mercado | −0,229 |
| R cuadrado | 0,0197 |
| p-valor de la beta | 0,0268 |
| Trayectorias simuladas | 10.000 |
| Semilla | 20250101 |
Treinta y una comprobaciones respaldan el libro. Todas pasan.
La simulación coincide con el supuesto sobre el que se construyó. Es un resultado de consistencia, no una validación del supuesto.
Qué muestran treinta y una comprobaciones
Las comprobaciones se agrupan en cuatro bloques, y cada uno prueba una capa distinta.
Los datos (3 comprobaciones). 249 rentabilidades logarítmicas de 250 precios, ningún cierre cero o negativo, fechas estrictamente crecientes. Son elementales y son lo primero que se rompe: una serie desordenada cambia sin avisar cada rentabilidad y cada estadística posterior. La limpieza de esa serie está en la guía de limpieza de datos.
Las identidades (4 comprobaciones). La volatilidad anualizada es igual a la desviación típica diaria por la raíz cuadrada del año bursátil; la beta es igual a la correlación por el cociente de las dos volatilidades; el R cuadrado es igual a la correlación al cuadrado; el p-valor está en [0,1]. Cada una es una relación que debe cumplirse con independencia de los datos, así que un fallo es siempre un error de implementación.
La simulación (7 comprobaciones). La semilla es un entero distinto de cero, así que la ejecución es reproducible. El recuento de trayectorias es 10.000. Las extracciones aleatorias tienen media cero y desviación típica 1. La media y la desviación típica simuladas coinciden con la deriva y la volatilidad analíticas. Los percentiles coinciden con los percentiles lognormales analíticos.
Las pruebas de ordenación (4 comprobaciones). La escalera de percentiles (P5 por debajo de P25, por debajo de P50, por debajo de P75, por debajo de P95) se cumple de principio a fin, tanto para la distribución simulada como para la analítica.
Por qué una simulación necesita una respuesta analítica
Un Monte Carlo solo es comprobable si sabes qué debería producir. Aquí la respuesta es una distribución lognormal: dados la deriva y la volatilidad, los percentiles 5, 25, 50, 75 y 95 a un año tienen forma cerrada.
| Percentil | Simulado | Analítico | Brecha |
|---|---|---|---|
| 5 | −0,3468 | −0,3453 | 0,0015 |
| 25 | −0,0905 | −0,0958 | 0,0053 |
| 50 | 0,0822 | 0,0776 | 0,0046 |
| 75 | 0,2535 | 0,2510 | 0,0025 |
| 95 | 0,4954 | 0,5005 | 0,0051 |
La mayor brecha es 0,0053 en términos de rentabilidad logarítmica, que es el error de muestreo de 10.000 trayectorias y no un error de modelización. Esa es la comprobación que hace creíble la simulación: el modelo no solo produce una distribución, produce la distribución que la teoría predice.
La beta que es significativa y no explica nada
La beta es −0,229 con un p-valor de 0,0268, estadísticamente significativa al nivel del 5 %. El R cuadrado es 0,0197, lo que significa que el índice de mercado explica el 2 % de la variación de las rentabilidades de este activo.
Ambos hechos son ciertos y apuntan en direcciones opuestas para quien los lea deprisa. Una beta significativa dice que es improbable que la estimación sea cero; un R cuadrado del 2 % dice que la relación es demasiado débil para explicar rentabilidades. El libro presenta ambos, adyacentes, que es la única forma honesta de presentar una regresión sobre 249 observaciones.
El resto de la serie
Rentabilidades y valor temporal son los datos y las tres estadísticas básicas. El árbol de probabilidad es el objeto más pequeño con probabilidades que tienen que sumar 1. El Monte Carlo es la ejecución de 10.000 trayectorias frente a su forma cerrada. La regresión es la beta que es significativa y no explica nada. La frontera eficiente trata de restricciones sobre un optimizador que este libro no contiene. Las pruebas fuera de muestra son la prueba que falta. El artículo de integración es cómo encajan las 31 comprobaciones.
Lo que la muestra no puede decirte
La hoja de límites los declara, y cuatro importan.
Un activo, una serie. Sin cartera, sin segundo activo, sin matriz de covarianzas. Lo que la simulación diga sobre el Activo A no dice nada sobre una cartera de ellos. La capa de cartera que consume una matriz de covarianzas es el optimizador de carteras.
La distribución se supone, no se prueba. Las rentabilidades se modelan como normales en términos logarítmicos. El libro no prueba la serie de precios en busca de normalidad, autocorrelación ni agrupamiento de volatilidad. Supone lognormal y después comprueba la simulación frente a ese supuesto.
Sin prueba fuera de muestra. Cada estadística se calcula sobre las 249 observaciones completas. No se reserva nada, así que nada demuestra que el modelo prediga.
La semilla lo hace reproducible, no correcto. Un generador con semilla significa que salen las mismas trayectorias cada vez. No significa que las trayectorias se extraigan de la distribución correcta. La comparación de percentiles es lo que prueba eso.
El resumen útil es el que ya dan los cuatro bloques: los datos están limpios, las identidades se cumplen, la simulación reproduce su respuesta analítica y la regresión es estadísticamente significativa mientras no explica casi nada. Tres de esas cosas son comprobaciones; la cuarta es un juicio que el libro entrega a quien lee.
Con la semilla en una celda de Mica, toda la simulación se puede volver a ejecutar y comprobar con las mismas trayectorias.
Preguntas frecuentes
¿Cuántas simulaciones de Monte Carlo debo ejecutar?
Las suficientes para que la estadística que declaras haya convergido; 10.000 trayectorias es un punto de partida habitual. Este libro usa 10.000 a partir de una semilla guardada en una celda (20250101), así que la misma ejecución se puede repetir exactamente.
¿Cómo se valida una simulación de Monte Carlo?
Compárala con un caso que tenga respuesta en forma cerrada, después comprueba la convergencia al aumentar las trayectorias y la repetibilidad con una semilla fija. Aquí los percentiles del 5 al 95 están dentro de 0,0053 de los valores lognormales en forma cerrada.
¿Es útil una beta estadísticamente significativa si el R cuadrado es bajo?
La significancia dice que es improbable que la pendiente sea cero; el R cuadrado dice cuánta variación explica. Aquí la beta es significativa con p = 0,0268, pero el R cuadrado es 0,0197, así que el mercado explica alrededor del 2 % de la variación y la beta es un mal predictor aunque sea real.
¿Por qué poner semilla a una simulación de Monte Carlo?
Una semilla hace que la ejecución sea reproducible: la misma semilla y las mismas extracciones dan la misma respuesta, así que una comprobación se puede volver a ejecutar y auditar. Nada de esta simulación usa ALEATORIO() (RAND() en inglés), que no es reproducible.