
La prueba fuera de muestra que el libro no hace
Cada estadística de este libro se calcula sobre los mismos 249 días, así que nada está fuera de muestra. Una división necesitaría más datos de los que contiene el paquete de entrada; las tres formas en que se produce filtración son el preprocesamiento sobre la muestra completa, las ventanas solapadas y la elección de la división después de ver los resultados.
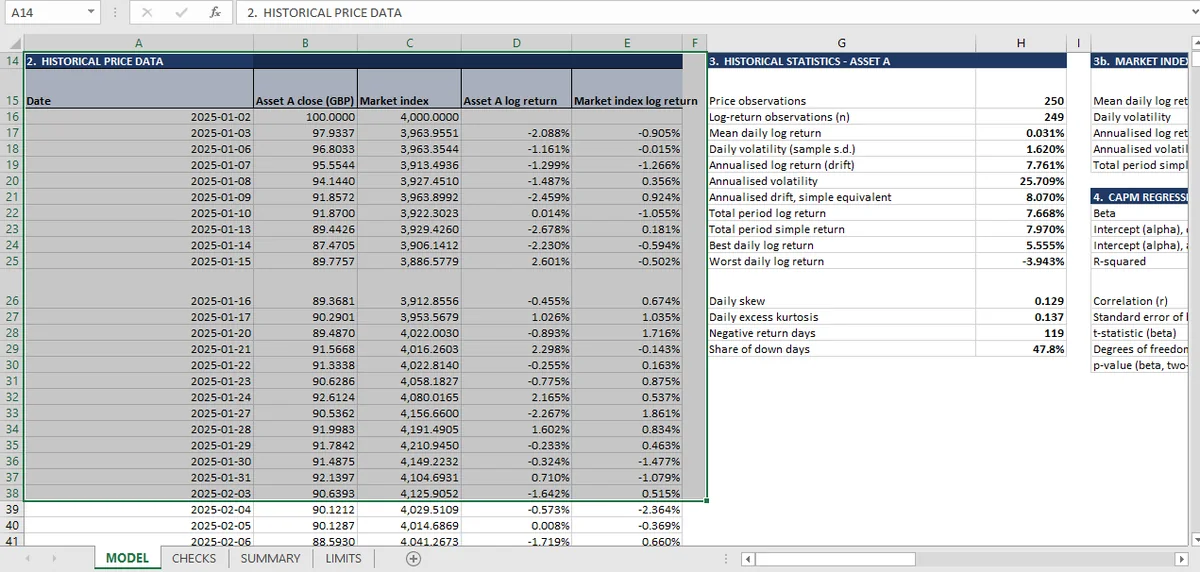
El libro cuantitativo usa 249 rentabilidades diarias para todo: la volatilidad, la deriva, la regresión, la simulación. Cada estadística se calcula sobre la muestra completa, y no se reserva nada.
Eso es un límite, no un error. El trabajo del libro es comprobar que la aritmética es correcta, y una estimación con la muestra completa es la forma más limpia de hacerlo. Pero quien lea el 25,71 % de volatilidad y la beta de −0,229 como descripciones del activo se ha saltado un paso, porque ambas cifras describen los 249 días con los que se ajustaron.
Qué significa fuera de muestra
Divide la serie en dos. Estima con la primera parte, evalúa con la segunda. La evaluación está fuera de muestra porque la segunda parte no desempeñó ningún papel en el ajuste.
El resultado suele ser peor que el ajuste en muestra, y el tamaño del deterioro es la información. Un modelo que ajusta el 20 % de la varianza en muestra y el 2 % fuera de muestra estaba ajustando ruido. Uno que ajusta el 15 % y el 12 % ha encontrado algo.
Para un solo activo con un año de datos, una división deja muy poco a cada lado para decir algo. Por eso el libro no la hace, y por eso hacerla bien requiere más datos de los que contiene el paquete de entrada.
Las tres formas en que una división tiene fuga
Preprocesamiento sobre la muestra completa. Si las rentabilidades se estandarizan, se recortan (winsorizan) o se centran en la media usando toda la serie y después se dividen, el conjunto de prueba ha influido en el modelo. La media y la desviación típica tienen que venir solo de la ventana de entrenamiento.
Ventanas solapadas. Un modelo entrenado con los días 1–150 y probado con los días 100–249 se solapa en los días 100–150, que están en ambos. El solapamiento no es una fuga pequeña; es que el modelo se está probando con datos que ya vio.
Elegir la división después de ver los resultados. Probar cinco divisiones y presentar la mejor es selección en muestra vestida con una etiqueta fuera de muestra. La división tiene que fijarse antes de ajustar el modelo.
Ninguna de estas cosas es exótica. Las tres son invisibles en una tabla final de estadísticas, y por eso la comprobación tiene que ser estructural: el cálculo que produce el estadístico de prueba no debe poder ver las filas de prueba.
Qué puede afirmar una hoja de comprobaciones
Cuatro afirmaciones, todas mecánicas.
- La ventana de entrenamiento termina antes de que empiece la ventana de prueba.
- Cada estadística usada para ajustar el modelo se calcula solo con la ventana de entrenamiento.
- El conjunto de prueba no se toca hasta el paso de evaluación.
- Se presentan los resultados en muestra y fuera de muestra, adyacentes.
La última es la importante, y es la que más a menudo se salta. Una tabla que solo muestra la cifra fuera de muestra esconde cuánto se sacrificó; una tabla que muestra ambas permite a quien lee ver el deterioro y juzgarlo.
El libro cuantitativo no lleva estas comprobaciones, y su hoja de límites tampoco las menciona. Esa es la brecha honesta: el modelo comprueba lo que calculó y no dice nada sobre si la muestra es lo bastante larga, o lo bastante representativa, para respaldar una previsión.
Por qué esto importa para los demás temas
Todos los modelos de esta serie usan una muestra fija: cuatro años de cuentas, una serie de precios, una hoja de condiciones. En cada caso las comprobaciones establecen consistencia interna, y en cada caso la pregunta «¿se mantendría esto con datos distintos?» queda abierta.
La división del trabajo es razonable para una demostración, pero deja de serlo cuando el modelo se usa para predecir. La diferencia entre ambas cosas es exactamente la división descrita aquí.
El artículo de Monte Carlo es la única pieza que compara el modelo con algo fuera de sí mismo, la distribución analítica. Esa comparación solo está disponible porque la distribución se supuso. El artículo de regresión muestra la misma tensión en un p-valor, y para ver las 31 comprobaciones en orden, empieza en la página de métodos cuantitativos. Las estadísticas que una división dividiría están en rentabilidades y valor temporal, y la comparación analítica que sustituye a una prueba externa está en el Monte Carlo.
En Mica, la ventana de estimación queda en la hoja como un rango declarado, que es lo primero que habría que cambiar para hacer una división.