
AI 財務建模排行榜量的是什麼
公開排名評的是速度、格式與資料準確度。受測工具裡,沒有任何一個用計息餘額來推算利息,所以沒有一個真正做出三表模型。排名沒評的,是可驗證性:完成的檔案裡,有沒有審閱者能重新執行的檢查。
最有名的 AI 財務建模工具測試,來自 Wall Street Prep。它要求每個工具為 Apple 建一份完整整合的三表模型:從 10-K 與第四季財報取三年歷史資料,從市場共識取四年預測,格式要像投資銀行做的模型。接著,再依初階分析師的標準替這些工具評分。
結果如下,出自公開排名:Shortcut 5.9、Claude 5.5、Copilot 4.4、ChatGPT 2.5。初階分析師 6.4 分,中階 7.9 分,頂尖 9.4 分。沒有任何工具觸及人類分數區間的低標。
這些評分項目,對一個必須把模型交到同事手上的人來說,確實切中要害:工具多快理解任務、歷史數字對不對、格式像不像銀行出品、資料來源站不站得住腳、預測結構合不合理。
這是一份好測試,也回答了一個真實問題:如果我請工具先寫一份模型草稿,這份草稿有多少可以直接沿用。但它沒有回答真正決定模型能不能用的問題:完成的檔案能不能被檢查。
排行榜漏掉了什麼:可驗證性
那份測試裡有兩個項目很接近可驗證性,卻沒有真的碰到。資料來源問的是工具有沒有交代數字從哪來;結構問的是報表彼此合不合得起來。兩個都沒有問審閱者真正會問的問題:我能不能重跑一次、得到同樣的答案?我能不能找到它開始不成立的地方?
這份基準測試有一個結果,正好說明這個缺口要付多少代價。在循環性這個項目下,它自己的標題就是 All failed:「沒有任何工具根據現金與債務餘額預測利息收入與費用」,因此「模型裡根本沒有把循環性建進去」。談到債務時則寫:「沒有人正確處理債務」,而且多數工具「依賴調整項,而不是正確的整合」。
放在三表模型裡,這些不是小疏漏。利息如果不隨計息餘額變動,它就只是一個常數;一份靠調整項才平掉的資產負債表,就是每一期都通過恆等式、也每一期都錯的資產負債表。這些工具不是解不開一道難題;它們是繞開了那道題,而且照樣拿到十分裡的 4.4 到 5.9 分。
排行榜看不到這件事,因為排行榜是拿產出對照評分表。可驗證性看的是路徑,不是產出。
一份可檢查的模型,該用什麼來評分
替代方案不是替同一份草稿換一張更好的評分表,而是換一個問題,而且問的對象是檔案、不是工具:這本完成的活頁簿滿足多少條檢查條件?作者以外的人能不能證明這一點?
這六種檢查類型就涵蓋得住,而且每一種產出的是數字,不是印象:
| 檢查類型 | 它產出什麼 | 排行榜為何看不到 |
|---|---|---|
| 結構性 | 每一期都成立的恆等式 | 模型可以只在最後一欄平 |
| 一致性 | 各期之間彼此相符的公式 | 手動修補看起來就像一條公式 |
| 限制條件 | 解所滿足的限制條件 | 超出限制的最佳解,看起來仍像個答案 |
| 收斂性 | 兩種方法、一個數字、一個差值 | 單一方法無法稽核自己 |
| 敏感度 | 反應的方向與合理性 | 錯得一路平順、看不出破綻的模型,其他檢查全都過 |
| 已知行為 | 認得已知特性,不誤判 | 正確的模型可能被標成錯 |
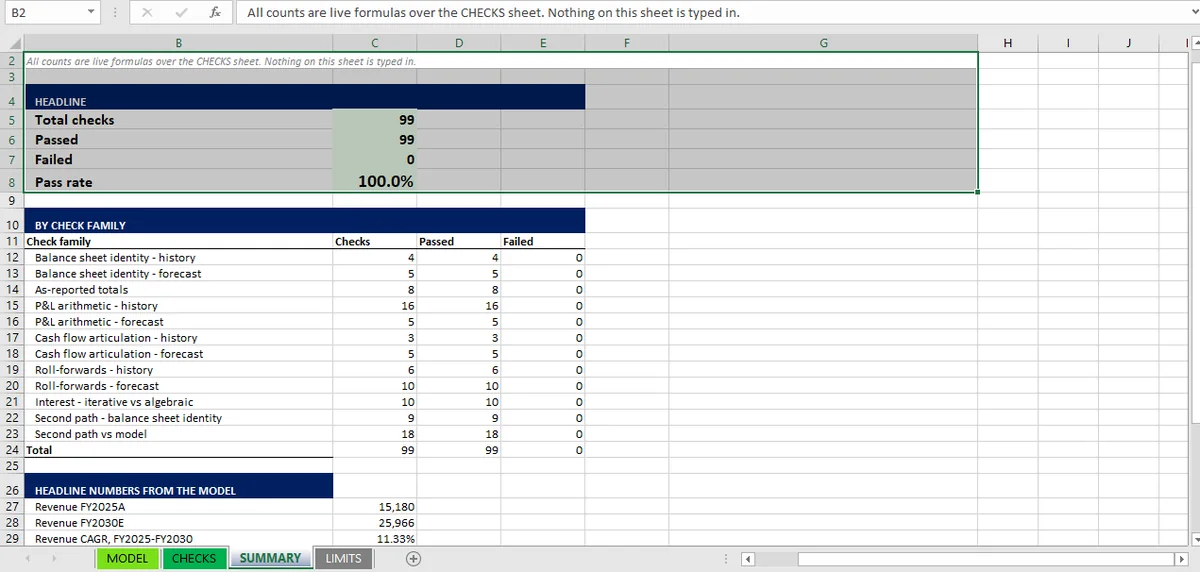
這個系列裡的活頁簿,就是為了產出這些數字而做,結果一點也不光鮮:99 條檢查、99 條通過,唯一的發現是期末現金 −1,113,因為模型裡沒有編列任何融資來源。真正重要的不是 99,而是期末現金那個數字;那是任何十分制分數都不會浮現出來的東西。
各家工具在檢查上的比較
目前還不能比;與其暗示出一份排名,不如把原因說清楚。
要對一個工具跑整套檢查流程,意思是給它同一份輸入資料、拿著同一份標準答案,再用同一套 99 條檢查條件去評它交回來的活頁簿。這件事只做過一次,只做過一個模型,而且只由一個團隊做(就是這一份);結果是示範,不是調查。
目前能比的,只有這些工具在公開測試裡、檢查通常會失守的地方表現如何:
| 衡量項目 | Shortcut | Claude in Excel | Copilot | ChatGPT |
|---|---|---|---|---|
| 依現金與債務餘額預測利息 | 否 | 否 | 否 | 否 |
| 正確處理債務明細表 | 否 | 否 | 否 | 否 |
| 公開測試總分 | 5.9 | 5.5 | 4.4 | 2.5 |
四個工具,在兩項決定「三表模型算不算三表模型」的關鍵上,答案完全一致。這是針對某一次特定測試、某一個特定日期所公開的發現;目前要支持「產出草稿的速度與可驗證性,是兩個不同的構面」這個主張,它是最有力的證據。
這個結果並不證明沒有工具能通過檢查流程。這套流程只套用過一次,通過的是 Mica;讀這個結果,得附上一個再明顯不過的但書:模型和檢查都是同一個團隊做的。這也是為什麼這裡每篇文章都要把「同一本活頁簿裡的交叉檢查」和「外部稽核」分開,以及為什麼數字要完整公開,而不是只給摘要。
該問廠商什麼
如果你挑工具,是為了做一件別人得拿來當依據的事,排行榜只是起點,剩下的就是下面五個問題。這些問題在示範裡就答得出來,而且答案都能驗證真假。
- 它會不會在檔案裡留下一張檢查表? 不是一份報告,也不是聊天視窗裡的一段摘要,而是活頁簿裡真的會在模型變動時重新計算的列。
- 它有沒有把任何東西算兩次? 利息、殖利率、存續期間、選擇權價格。如果答案是沒有,就問它到底驗證哪一個量,又用什麼方式驗證。
- 我能不能刪掉一張明細表,看看哪裡會壞? 這是在測模型各個部分是真正連在一起,還是只是擺在旁邊。
- 限制表上寫了什麼? 不產出限制表的工具,等於宣稱模型什麼都涵蓋到了;而這種主張永遠不成立。
- 我明天能不能用同一個提示詞、對同一個檔案再跑一次? 這裡的關鍵是它有沒有留在本機:如果活頁簿在兩次執行之間離開了這台機器,證據鏈就出現了斷點。
Mica 把假設輸入與計算儲存格分開,所以情境一改,就能追到它動到了哪些輸出。這回答了問題一與問題五,而且可以在活頁簿裡驗證,不是在行銷頁面上驗證。
這些問題背後的工具版圖,可以看免費 Excel AI 工具指南 與 ChatGPT、Claude、Copilot 比較;動作機器人趨勢文 則是從品類層次來看。
誰該看這份排名,誰不該看
對某一種買方,公開分數回答的是真問題;對另一種買方,它給的答案卻會誤導人。
如果你先做一版模型,是為了邊做邊想,排行榜幾乎正好就是你要的。一個拿 5.9 分、十五分鐘就做完的工具,確實加快了你產出初稿的速度;至於讓它觸及不到人類分數低標的那些錯,反正你在初稿階段本來也會犯。先用它,再把你真正在意的部分重建一遍。
如果你先做一版模型,是為了交給別人,排行榜量錯了東西。那個分數描述的是一份草稿,一份稱職的分析師還得把它做完;它完全沒說,完成的檔案能不能讓沒參與建模的人審閱。那是檢查表的問題,而目前四個工具沒有一個答得出來。
如果你是替團隊採購軟體,兩項都要向廠商要。分數告訴你工具會不會被採用;檢查表告訴你產出能不能站得住腳。一個分數很高、卻不留任何證據的工具,等於把審閱成本從分析師身上,轉移到簽核的人身上;那是風險的實質轉移,不是省成本。
怎麼自己跑這套檢查流程
這些都不需要廠商配合。這套流程可以在任何活頁簿上跑,一個下午就能做完,檔案甚至不用關。
挑五條檢查條件,不要挑九十九條。 每一期一條資產負債表恆等式、一條逐期結轉、一條串接測試、一項兩種方法的比對、一個敏感度方向。五條就足以分辨「模型」和「草稿」,也小到能做得完。
把它們寫在另外一張工作表上。 每一列都該有兩個值、一個差值,和一個通過標記。用文字描述的檢查只是空話;寫成儲存格的檢查才是證據。
標明每一條檢查讀的是哪個儲存格。 這是大家最常跳過的一步,也正是把警訊定位到具體儲存格的一步。少了它,一條沒過的檢查只會告訴你模型錯了,不會告訴你錯在哪。
故意讓模型出錯。 改一個驅動因子,確認檢查還是全過,再改回來。如果明明不該有任何變動,檢查結果卻反過來,那表示檢查錯了,或者連結錯了。不管是哪一種,你都學到了靜態檔案不會告訴你的事。
把檢查表留在你送出的檔案裡。 只存在你自己工作副本裡的檢查表,等於在對一個送出後就不存在的模型提出主張。跟著檔案一起走的檢查表,才能讓收到的人稽核這個模型。
上面這套流程,就是六種檢查類型 描述的那一套,套用在產出這個檔案的任何工具上。它刻意做得很無聊,而它的價值就在於:不必信任跑檢查的那個人。
這個排名對挑選工具代表什麼
對挑選工具的意義,取決於你要的是草稿還是可驗證的成品。
三個結論,依確定程度排列。
產出草稿的速度已經不是問題,也不再是差異化所在。 公開測試裡的每一個工具,都在大約一小時內做出三表模型,兩個領先的工具更只花了約十五分鐘。用速度來挑,等於在差距最小的項目上挑。
可驗證性還沒解決,而且在排行榜裡完全看不到。 公開測試裡沒有任何一個工具,是用計息餘額來推算利息。光是這個疏漏,就足以讓一份三表模型不配稱為三表模型;但這四個工具照樣都拿到區間中段的分數。
檢查是買方做得到的,不是只有廠商能做。 直接要檢查表。如果工具產不出來,這份模型不管看起來多好,都只是草稿;而十二條勾稽 手動執行,一個下午就能完成。這就是把模型留在 Excel、而不是關進黑箱的全部理由:證據會跟著檔案一起走。
數字背後的方法,請從六種檢查類型 開始;唯一一個從頭到尾做過的模型,看三表活頁簿;而每一個公開工具目前都過不了的那條檢查,看利息循環參照。
*本文比較公開測試結果與一套方法論,不構成投資建議。沒有任何廠商付費取得曝光,上述結果均引自文中所引用的來源。*
輸入與計算分開放置,Mica 的活頁簿因此讓買方能自己重新執行檢查表。