
AI財務モデリング・ランキングが測っているもの
公表されているランキングは、速さ、書式、データの正確さを採点しています。しかしテストされたどのツールも、利息を生み出す残高から利息を予測しておらず、実質的な3表モデルを作ったツールはありません。欠けている軸は検証可能性です。完成したファイルに、レビューする人が再実行できるチェックが入っているかどうかです。
財務モデリング向けAIツールの最も有名なテストはWall Street Prepのものです。各ツールに、Appleの完全に統合された3表モデルを作るよう求めます。10-Kと第4四半期のリリースから3年分の実績、コンセンサスから4年分の予測、銀行のモデル風の書式です。ツールは、研修中のアナリストと同じ基準で採点されます。
公表されたランキングによると、Shortcutが5.9点、Claudeが5.5点、Copilotが4.4点、ChatGPTが2.5点です。下位のジュニアアナリストは6.4点、中位は7.9点、上位は9.4点でした。人間の水準の下限に届いたツールはありませんでした。
モデルを同僚に引き渡す立場の人にとって、どのカテゴリが採点されているかは重要です。ツールが課題をどれだけ早く理解したか、実績値が正しかったか、書式が銀行らしく見えたか、出典が確かだったか、予測の構造がしっかりしていたか。
これはよいテストで、実際の問いに答えています。ツールにモデルの下書きを頼んだとき、下書きのどれだけを残せるのか、という問いです。しかし、モデルを使えるかどうかを決める問いには答えていません。完成したファイルを検証できるのか、という問いです。
ランキングが測っていないもの:検証可能性
そのテストのカテゴリのうち2つは、検証可能性に近づきながら、届いていません。出典は、数字がどこから来たかをツールが説明できるかを問います。構造は、計算書がつながっているかを問います。どちらも、レビューする人が問う問いには答えていません。そのモデルを再実行して同じ答えが得られるか、そしてどこで成り立たなくなるかを見つけられるか、という問いです。
このベンチマークは、その隔たりのコストを示す結果を1つ報告しています。循環性の項目の見出しは All failed、つまり全ツール失敗です。「どのツールも、現金と負債の残高から受取利息と支払利息を予測しなかった」ため、「モデルに循環性は埋め込まれていなかった」としています。負債については「どのツールも負債を正しく扱わなかった」と述べ、ほとんどが「適切な統合ではなくプラグに頼った」としています。
3表モデルでは、これは小さな抜けではありません。利息の計算対象となる残高に連動しない利息は定数であり、プラグで合わせた貸借対照表は、毎期恒等式を通りながら、毎期間違っています。ツールは難しい問題を解けなかったのではなく、問題を避けたうえで10点満点中4.4から5.9を取ったのです。
ランキングにはこれが見えません。ランキングは成果物を評価基準と比べるからです。検証可能性は作り方(プロセス)の性質であって、成果物の性質ではありません。
検証できるモデルなら何を採点すべきか
代わりになるのは、同じ下書きに対するよりよい評価基準ではありません。ツールではなくファイルに問う、別の問いです。完成したワークブックがいくつの主張を満たすのか、そして作者以外の人がそれを示せるのか、という問いです。
6種類のチェックがそれを捉え、どれも印象ではなく数字で示します。
| チェックの種類 | 何を出すか | ランキングが見逃す理由 |
|---|---|---|
| 構造 | 毎期成り立つ恒等式 | 最後の列だけで合うモデルもある |
| 一貫性 | 期間をまたいで一致する数式 | 手作業の修正は数式に見える |
| 制約 | 解が満たした制約 | 範囲外の最適解も答えに見える |
| 収束 | 2つの手法、1つの数字、1つの差 | 単一の手法は自己監査できない |
| 感応度 | 反応の方向と妥当性 | 滑らかに間違ったモデルは他をすべて通る |
| 既知の挙動 | 既知の挙動を誤判定せずに認識する | 正しいモデルが誤りと判定され得る |
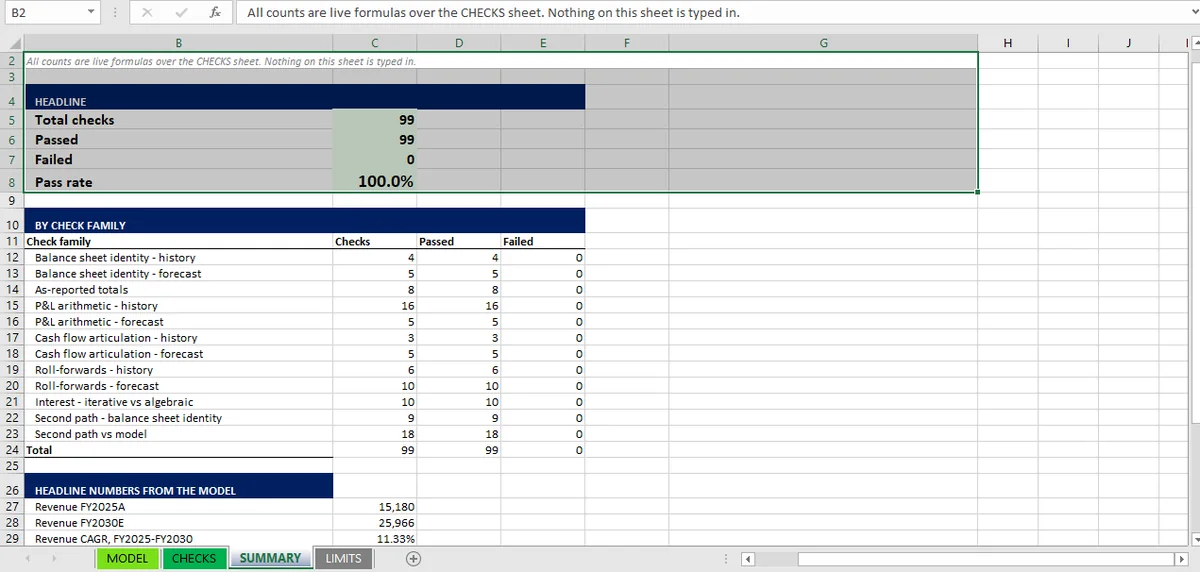
このシリーズのワークブックは、まさにこれらの数字を出すために作られました。結果は地味です。99件のチェックはすべて合格し、発見は1つだけでした。資金調達の行がないため、期末現金が −1,113 になることです。重要なのは99という数字ではなく、最後に示したその数字です。10点満点のスコアでは、この数字は浮かび上がりませんでした。
チェックの観点でツールを比べると
まだ比べることはできません。ランキングをほのめかすのではなく、理由を説明しておきます。
ツールにチェック手順を適用するには、同じ入力セットを与え、解答を伏せたまま、返ってきたワークブックを同じ99項目で採点します。それは1つのモデルについて、1つのチームが1回行っただけです(このチーム)。結果は調査ではなく実演です。
公表されたテストから比べられるのは、チェックがたいてい失敗する場面で、ツールがどう振る舞うかです。
| 測定項目 | Shortcut | Claude in Excel | Copilot | ChatGPT |
|---|---|---|---|---|
| 現金と負債の残高から利息を予測 | いいえ | いいえ | いいえ | いいえ |
| 負債スケジュールを正しく扱う | いいえ | いいえ | いいえ | いいえ |
| 総合スコア、公表テスト | 5.9 | 5.5 | 4.4 | 2.5 |
4つのツールが、3表モデルとして成立するかを決める2つの点で、同じ答えを出しています。これは、特定の日の特定のテストについて公表された結果です。下書きの速さと検証可能性が別の軸だという主張を支える、現時点で最も強い証拠です。
これは、どんなツールもチェック手順に合格できないという証明ではありません。手順が適用されたのは1回だけで、合格したツールはMicaでした。この結果は、当然の留保を付けて読むべきです。モデルを作ったのもチェックを書いたのも同じチームだということです。そのため、ここにあるすべての記事は、1つのワークブック内のクロスチェックと外部監査を区別し、数字を要約せず全文で公開しています。
ベンダーに聞くべきこと
信頼される仕事のためにツールを選ぶなら、ランキングは出発点にすぎません。残りは次の5つの問いで判断します。いずれもデモで答えられ、答えは反証可能です。
- ファイル内にチェックシートを残すか。 レポートでも、チャット画面の要約でもありません。モデルが変わると再計算される行がワークブックにあるかです。
- 何かを2回計算するか。 利息、利回り、デュレーション、オプション価格。答えがノーなら、どの量をどのように検証するのかを聞いてください。
- スケジュールを削除して、何が壊れるか見られるか。 モデルの各部分がつながっているのか、単に隣り合っているだけなのかを試します。
- 制約・限界シートには何が書かれているか。 制約・限界シートを出さないツールは、モデルがすべてを網羅していると主張しています。まず間違いなく偽になる主張です。
- 明日、同じファイルに同じプロンプトを再実行できるか。 ここではローカル環境で動くことが重要です。実行のたびにワークブックが自分のマシンの外に出るなら、証拠の連鎖に穴があります。
Micaのワークブックでは、前提の入力と計算セルが分かれています。シナリオを変えたとき、どのアウトプットまで影響したかをたどれるのはそのためで、問い1と5への答えも、マーケティングページではなくファイルの中で確かめられます。
これらの問いの背景にあるツールの状況は、無料のExcel AIツールガイドとChatGPT/Claude/Copilotの比較で比較しています。アクションボットのトレンド記事はカテゴリ全体の視点です。
このランキングを読むべき人、読まなくていい人
公表されたスコアは、ある種の買い手には実際の問いに答え、別の買い手には誤解を招く答えを与えます。
考えるために下書きするなら、ランキングはほぼそのまま役に立ちます。5.9点を取り、15分で仕上げるツールは、最初の版を作る速さを本当に変えます。人間の水準に届かない原因になっている誤りは、最初の下書きなら自分でも犯していたはずのものです。使ってから、重要な部分を作り直してください。
引き渡すために下書きするなら、ランキングは間違った道具です。スコアが示すのは、有能なアナリストがまだ仕上げなければならない下書きです。そのファイルを、その場にいなかった人がレビューできるかは分かりません。それがチェックシートの問いで、現在4つのツールのどれも答えていません。
チームのためにソフトウェアを買うなら、両方を求めてください。スコアはそのツールが導入されるかどうかを教え、チェックシートはその成果物を説明できるかどうかを教えます。高得点で証拠を残さないツールは、レビューのコストをアナリストから承認する人へ移したのであり、節約ではなくリスクの移転です。
チェックの手順を自分で実行する方法
これらはベンダーの協力を必要としません。手順はどのワークブックでも、ファイルを開いたまま、午後のひとときで実行できます。
主張は99ではなく5つに絞る。 期間ごとの貸借対照表の恒等式を1つ、ロールフォワードを1つ、連動のテストを1つ、2手法の比較を1つ、感応度の方向を1つ。5つあればモデルと下書きを見分けられ、終えられる大きさです。
空きシートに数式として書く。 各行に2つの値、差、合否フラグを置きます。文章で書いたチェックは願望にすぎません。セルに置いたチェックが証拠です。
各チェックが読むセルを名指しする。 ここは多くの人が飛ばす手順ですが、失敗したときに原因の場所が分かるようになります。これがないと、失敗したチェックはモデルが間違っていることしか教えず、どこが間違っているかは教えません。
わざとモデルを壊す。 ドライバーを1つ変え、チェックがまだ通ることを確認し、元に戻します。何も動くはずのないときにチェックが反転するなら、チェックが間違っているか、リンクが間違っています。どちらにせよ、静的なファイルでは教えてくれないことを学べます。
送るファイルにシートを残す。 自分の作業コピーにあるチェックシートは、送った瞬間に存在しなくなるモデルについての主張です。モデルと一緒に届くシートだけが、受け取った誰にとってもモデルを監査可能にします。
これは6種類のチェックで説明したのと同じ手順を、ファイルを作ったツールに当てはめたものです。あえて地味な手順にしているのは、実行した人を信頼しなくても済むことに価値があるからです。
このランキングがツール選びに意味すること
ランキングはツール選びの出発点であり、最終的な判断基準ではありません。確信度の高い順に、3つの結論を述べます。
下書きの速さは解決済みで、もう差別化にならない。 公表されたテストのすべてのツールが1時間ほどで3表モデルを作り、上位2つはおよそ15分でした。速さで選ぶのは、ばらつきが最も小さい基準で選んでいることになります。
検証可能性は未解決で、ランキングでは見えない。 公表されたテストで、利息を生み出す残高から利息を予測したツールは1つもありません。その1つの抜けだけで、3表モデルは3表モデルでなくなります。それでも、4つのツールは中間のスコアを取っています。
チェックはベンダーだけでなく買い手のものでもある。 チェックシートを求めてください。ツールが出せないなら、どんなに見栄えがよくてもそのモデルは下書きです。12本の突合なら手作業でも午後半日あれば実行できます。モデルをブラックボックスではなくExcelに置く理由はこれに尽きます。証拠がファイルと一緒に届くからです。
数字の背後にある方法は6種類のチェックから、最後まで通した1つのモデルは3表のワークブックから、現在すべての公表ツールが失敗しているチェックは利息の循環参照から読んでください。
*これは公表されたテスト結果と方法論の比較であり、投資助言ではありません。掲載に金銭を払ったベンダーはなく、上記の結果は引用元からそのまま引いています。*
Micaが入力と計算を切り離すため、チェックシートは買い手が自分で再実行できます。